Lokale Jev-Alternativen: Welche kleinen LLMs eignen sich als Fast Decision Layer?
Kurzantwort: Ja, kleine lokale Open-Weight-LLMs können für bestimmte Aufgaben eine praktikable lokale Jev-Alternative sein. In meinem Screening war Ministral 3 8B der überzeugendste Kandidat für schnelle, eng definierte Entscheidungen. Mehrere kleinere 1B- bis 4B-Modelle waren zwar schneller, qualitativ aber deutlich zu schwach. Und bei realistischeren Tests zeigte sich: Nicht das Modell allein entscheidet über die Qualität, sondern auch Decision Contract, State, verfügbare Evidenz und Evaluation mit echten Daten.
Redaktionell ergänzt am 4. November 2026: Die folgenden Messwerte stammen aus den bisherigen eigenen Tests. Diese Aktualisierung ergänzt ihre Einordnung und einen Überblick über spezialisierte Decision-Modelle; sie enthält keine neuen Modellmessungen.
Die wichtigsten eigenen Ergebnisse auf einen Blick
| Test | Ergebnis | Konsequenz für die Architektur |
|---|---|---|
| 13 lokale Modelle, jeweils 24 Screening-Fälle | Ministral 3 8B: 21/24 korrekt, p50 166 ms | Interessante Baseline für enge Entscheidungen; kein universeller Sieger |
| Tool Router mit Ministral 8B, 60 Fälle | 100 % schema-valide, 25 % korrekt | JSON-Validierung ersetzt keine fachliche Evaluation |
| Tool Router mit Qwen 3.5 9B und verändertem Contract, 60 Fälle | 51/60 korrekt, p50 694 ms | Modell und Contract gemeinsam betrachten; kein isolierter Prompt-Vergleich |
| E-Mail Attention Gate | 48/48 synthetisch korrekt; 22/35 reale Shadow-Reviews korrekt | Vor Automatisierung mit realistischen Daten im Shadow Mode prüfen |
Der entscheidende Befund: 100 Prozent synthetische Accuracy waren kein Nachweis für Produktionsreife. Auf realen E-Mails lag die Accuracy desselben Ansatzes bei 62,9 Prozent.
Was diese Messungen belegen – und was nicht
Die Testreihen beantworten unterschiedliche Fragen. Ihre Prozentwerte gehören deshalb nicht in eine gemeinsame Modellrangliste. Jev und die unten vorgestellten Spezialmodelle wurden nicht unter identischen Bedingungen mitgetestet.
Im Screening entspricht bereits eine einzige andere Entscheidung rund 4,2 Prozentpunkten. 21/24 gegenüber 19/24 ist ein Hinweis für weitere Tests, kein belastbarer Nachweis allgemeiner Überlegenheit. Ebenso lässt sich aus den einzelnen 4-bit- und 8-bit-Läufen kein genereller Qualitätsvorteil einer Quantisierung ableiten.
Die Latenzen beschreiben meinen damaligen lokalen Aufbau. Für eine reproduzierbare Gegenmessung braucht es zusätzlich genaue Hardware-, Runtime-, Modell- und Quantisierungsstände sowie Angaben zu Warm-up, Kontext und Parallelität. Synthetische Fälle und reale Shadow-Reviews bleiben getrennte Auswertungen.
Jev von TypeSafe verfolgt eine interessante Idee: Nicht jede Entscheidung innerhalb einer KI-Anwendung braucht ein großes generatives Sprachmodell.
Viele Entscheidungen in Agenten und automatisierten Workflows sind klein:
- Muss ich dafür im Web suchen?
- Welches Tool wird benötigt?
- Ist diese Nachricht jetzt relevant?
- Reicht die vorhandene Evidenz?
- Kann ein Workflow automatisch weiterlaufen?
- Muss ein Mensch eingreifen?
Ein großes Reasoning-Modell für jede dieser Entscheidungen aufzurufen, ist häufig unnötig langsam und teuer.
TypeSafe positioniert Jev als System One Model: unstrukturierter Zustand hinein, typisierte probabilistische Entscheidungen heraus. Statt beliebigen Text zu erzeugen, soll Jev speziell für schnelle Entscheidungen innerhalb von Software optimiert sein. Mehr zum Konzept habe ich im Grundlagenartikel Jev erklärt: Warum KI-Anwendungen nicht für jede Entscheidung ein LLM brauchen eingeordnet.
Das hat mich zu einer anderen Frage gebracht:
Brauche ich dafür tatsächlich ein spezialisiertes Modell wie Jev – oder kann ein kleines Open-Weight-LLM lokal eine ähnliche Rolle übernehmen?
Ich habe genau das getestet.
Nicht als direkten Jev-Benchmark. Ich hatte Jev nicht als identisch ausgeführten Vergleichskandidaten in meinem lokalen Testaufbau. Stattdessen habe ich die Architekturhypothese dahinter untersucht:
Wie weit kommen normale kleine lokale LLMs, wenn ich ihren Entscheidungsraum stark einschränke?
Die Ergebnisse waren deutlich differenzierter als erwartet.
Was wäre überhaupt eine lokale Jev-Alternative?
Jev ist nicht einfach ein kleines Chatmodell. TypeSafe beschreibt mit Noul, Choice und Score typisierte Entscheidungsprimitive. Die Anwendung definiert die möglichen Outputs vorher; Jev liefert strukturierte Entscheidungen sowie Wahrscheinlichkeiten beziehungsweise Confidence zurück. Die TypeSafe-Einführung zu System One und Jev beschreibt diesen Ansatz, die API-Dokumentation die Schnittstelle.
Meine lokalen Modelle funktionieren anders. Sie bleiben generative LLMs. Ich begrenze sie lediglich durch:
- einen kleinen Entscheidungsraum,
- einen expliziten Decision Contract,
- Structured Output,
- JSON Schema,
- sehr kurze Outputs,
- Temperature 0.
Ich versuche damit nicht, Jev technisch nachzubauen. Ich prüfe, ob ein Standard-LLM dieselbe Rolle innerhalb einer Architektur übernehmen kann.
Welche lokalen Jev-Alternativen habe ich getestet?
Für das erste Screening habe ich 24 bewusst kleine und eindeutige Fälle gebaut:
- 8 Binary Decisions
- 8 Choice Decisions
- 8 Scores von 0 bis 4
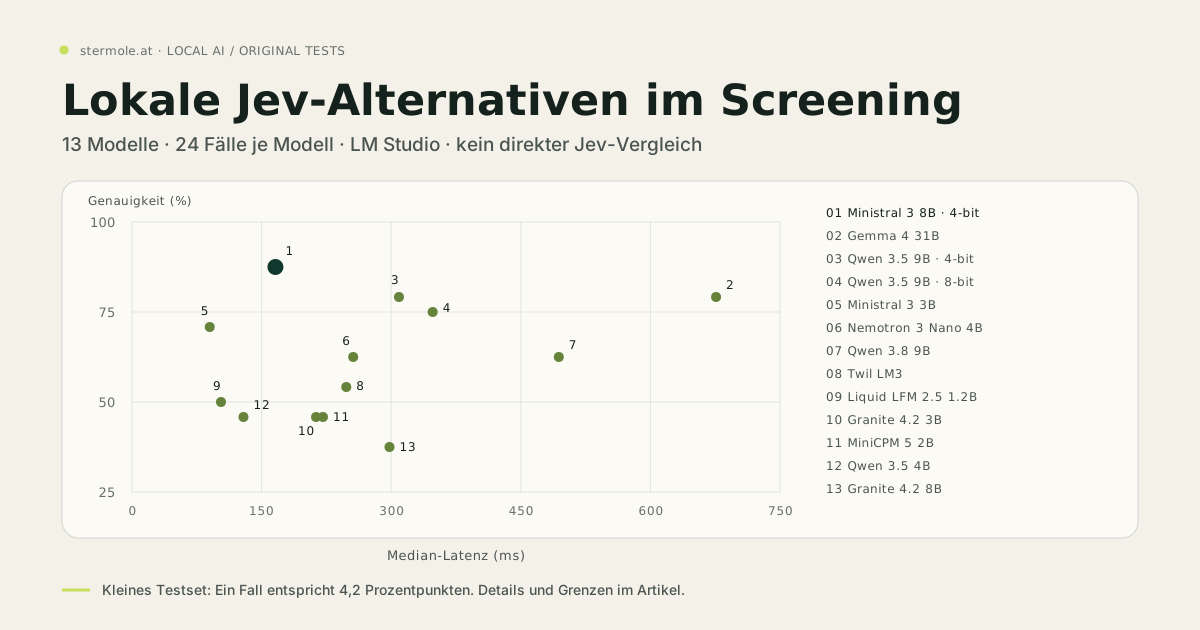
Die Modelle liefen lokal über LM Studio. Exact Match bedeutet hier die exakte Übereinstimmung mit der vorgegebenen Referenzentscheidung; p50 ist die Median-Latenz, p95 die Latenz, die 95 Prozent der gemessenen Antworten nicht überschritten. Gemessen wurden Exact Match, Schema Validity, p50/p95-Latenz und serielle Entscheidungen pro Sekunde.
Das Dataset ist klein. Es ist ein exploratives Screening, kein Nachweis einer allgemeinen Modellrangfolge.
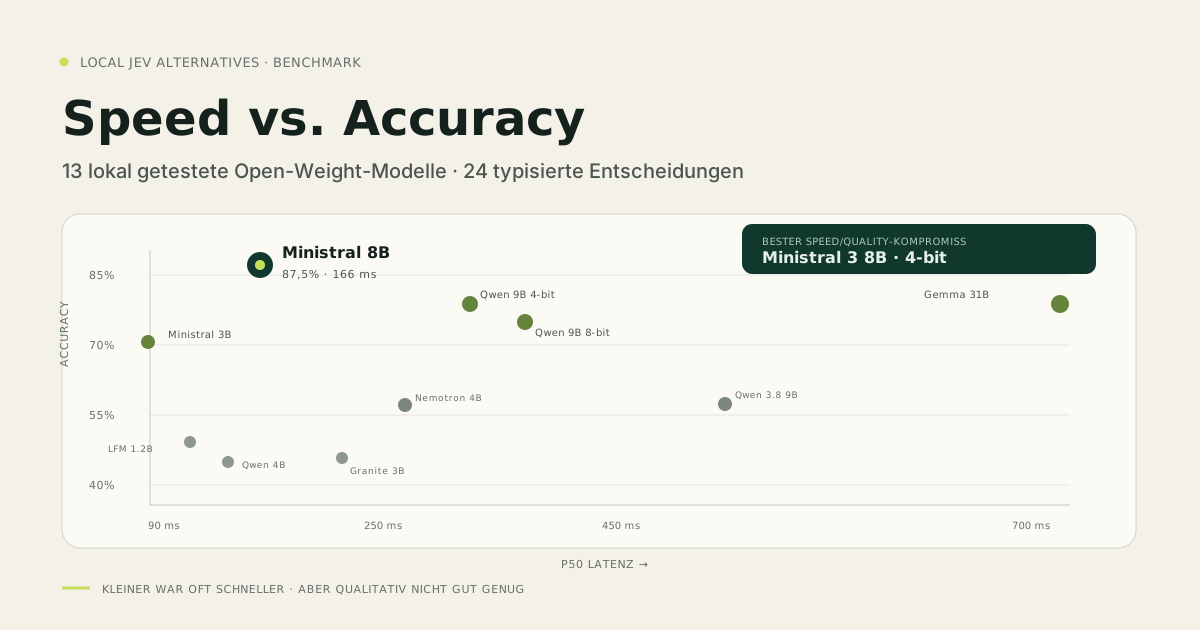 13 lokale Modelle im Verhältnis von Accuracy und Median-Latenz.
| Modell | Exact | Accuracy | p50 | p95 |
|---|---|---|---|---|
| Ministral 3 8B Instruct, 4-bit | 21/24 | 87,5 % | 166 ms | 189 ms |
| Gemma 4 31B IT | 19/24 | 79,2 % | 676 ms | 803 ms |
| Qwen 3.5 9B MLX, 4-bit | 19/24 | 79,2 % | 309 ms | 332 ms |
| Qwen 3.5 9B MLX, 8-bit | 18/24 | 75,0 % | 348 ms | 364 ms |
| Ministral 3 3B Instruct | 17/24 | 70,8 % | 90 ms | 105 ms |
| Nemotron 3 Nano 4B | 15/24 | 62,5 % | 256 ms | 276 ms |
| Qwen 3.8 9B MLX | 15/24 | 62,5 % | 494 ms | 1.163 ms |
| Twil LM3 MLX | 13/24 | 54,2 % | 248 ms | 636 ms |
| Liquid LFM 2.5 1.2B | 12/24 | 50,0 % | 103 ms | 279 ms |
| Granite 4.2 3B MLX | 11/24 | 45,8 % | 213 ms | 488 ms |
| MiniCPM 5 2B | 11/24 | 45,8 % | 221 ms | 549 ms |
| Qwen 3.5 4B MLX | 11/24 | 45,8 % | 129 ms | 143 ms |
| Granite 4.2 8B MLX, 4-bit | 9/24 | 37,5 % | 298 ms | 540 ms |
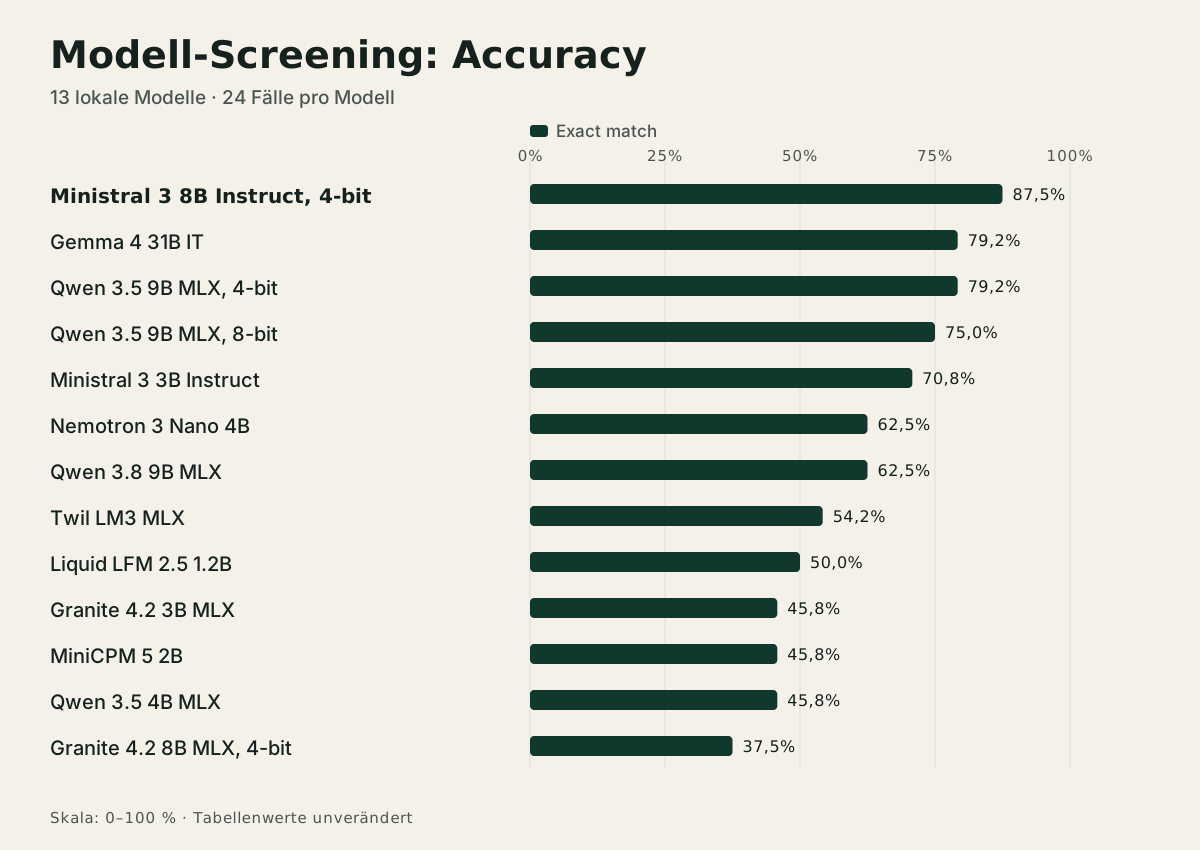 Accuracy aller 13 lokalen Modelle.
Die kleinsten Modelle waren in diesem Screening häufig zu ungenau
Der untere Teil der Tabelle ist fast interessanter als der Gewinner.
Liquid LFM 2.5 1.2B erreichte eine Medianlatenz von nur 103 Millisekunden. Das klingt ideal für einen Fast Decision Layer. Die Accuracy lag aber bei lediglich 50 Prozent.
Qwen 3.5 4B war mit 129 Millisekunden ebenfalls sehr schnell, erreichte jedoch nur 45,8 Prozent. Granite 3B, MiniCPM 2B und Granite 8B waren ebenfalls qualitativ nicht überzeugend.
Meine erste wichtige Erkenntnis war deshalb:
Eine lokale Jev-Alternative sollte nicht das kleinste Modell sein. Sie sollte das kleinste Modell sein, das den konkreten Decision Contract zuverlässig erfüllt.
Für ein automatisches Gate wäre mir eine Fehlentscheidung in fast jedem zweiten Fall trotz kurzer Latenz zu viel.
Größer war allerdings ebenfalls nicht automatisch besser. Granite 8B schnitt schlechter ab als Ministral 3B. Gemma 31B erreichte 79,2 Prozent, benötigte mit 676 Millisekunden Medianlatenz aber mehr als viermal so lange wie Ministral 8B.
Modellgröße allein erklärt die Qualität also nicht. Modellfamilie, Instruction Following, Quantisierung, Structured-Output-Verhalten und die genaue Entscheidungsaufgabe spielen ebenfalls eine Rolle.
In meinem Screening war Ministral 3 8B Instruct in 4-bit der beste Speed/Quality-Kompromiss: 87,5 Prozent Exact Match bei 166 Millisekunden Medianlatenz.
Auch Runtime-Interoperabilität gehört zur Modellqualität
Einige Versuche scheiterten bereits vor der eigentlichen Qualitätsfrage.
Ein Qwen-3.8-27B-Referenzlauf lieferte 0 von 24 vergleichbar validen Outputs. K2 Horizon ließ sich in meinem damaligen LM-Studio-Setup nicht erfolgreich laden.
Bei mehreren Reasoning-Modellen erschien das schema-valide Resultat außerdem in reasoning_content, während das normale content-Feld leer blieb. Nach einer eng begrenzten Normalisierung funktionierten einige dieser Modelle wieder.
Das wirkt wie ein Implementierungsdetail, ist im Produktionsbetrieb aber relevant:
Praktische Modellqualität beinhaltet auch vorhersehbares Runtime-Verhalten und zuverlässige Integration.
Structured Output ist noch keine richtige Entscheidung
Nach dem Screening habe ich einen realistischeren Use Case getestet: einen Tool Intent Router.
Er sollte genau eine von vier Aktionen auswählen:
ANSWER_DIRECTLYWEB_SEARCHREAD_REPORUN_CODE
Das Dataset bestand aus 60 Fällen, 15 pro Klasse.
Ministral 8B produzierte 60 von 60 schema-valide Antworten. Die Accuracy betrug trotzdem nur 25 Prozent. Das Modell entschied sich praktisch immer für ANSWER_DIRECTLY.
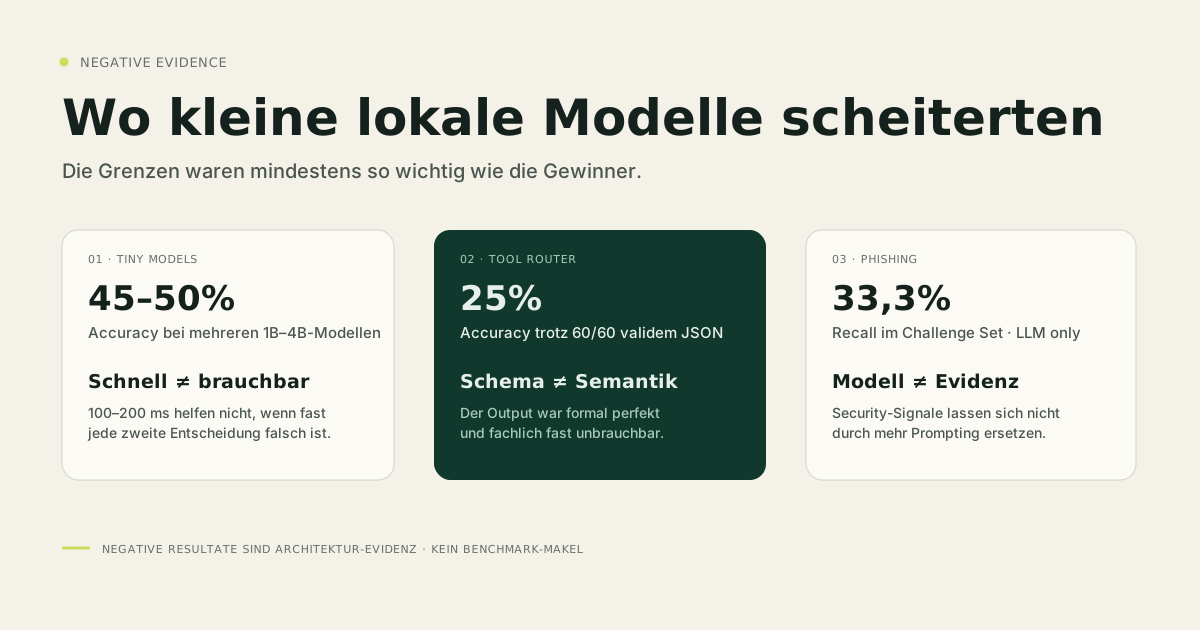 Drei wichtige Fehlversuche: sehr kleine Modelle, Tool Routing und Phishing.
Das war eine der wichtigsten Erkenntnisse:
Valides JSON ist noch keine valide Entscheidung.
JSON Schema löst das Syntaxproblem. Es löst nicht automatisch die semantische Aufgabe.
Modell und Decision Contract müssen zusammenpassen
Ich habe anschließend untersucht, warum der Router kollabierte.
Mit Qwen 3.5 9B testete ich ein expliziteres Router-Framing. Auf dem vollständigen 60-Case-Dataset erreichte das Modell danach:
- 60/60 schema-valid
- 51/60 korrekt
- 85 Prozent Accuracy
- p50 694 ms
- p95 739 ms
Wichtige Einschränkung: Zwischen diesen Läufen wurden sowohl das Modell als auch das Router-Framing geändert. Die Verbesserung von 25 auf 85 Prozent lässt sich deshalb weder allein dem Contract noch allein dem Modell zuschreiben. Für einen kausalen Vergleich wären kontrollierte Varianten mit jeweils nur einer Änderung erforderlich.
Die praktische Schlussfolgerung:
Ein Decision Contract besteht nicht nur aus einem Output-Schema. Er definiert die semantischen Grenzen zwischen den erlaubten Entscheidungen.
Für ein speziell trainiertes Decision Model kann ein Teil dieses Verhaltens bereits im Modell stecken. Bei einem allgemeinen lokalen LLM muss wesentlich mehr davon durch Architektur und Contract hergestellt werden.
Das E-Mail-Gate: 48 synthetische Fälle ohne Fehler
Besonders deutlich wurde das bei einem E-Mail Attention Gate.
Die Aufgabe war bewusst eng: Erzeugt diese E-Mail eine noch offene konkrete Handlung für den Empfänger?
Nur zwei Outputs waren erlaubt: NEEDS_ACTION oder NO_ACTION.
Auf 48 synthetischen Fällen erreichte Ministral 8B:
- Accuracy: 100 %
- Recall: 100 %
- Precision: 100 %
- 48/48 schema-valid
- p50: 286 ms
Der synthetische Test enthielt keine Fehlentscheidungen. Ob der Ansatz im Alltag trägt, musste ein Test mit realen E-Mails zeigen.
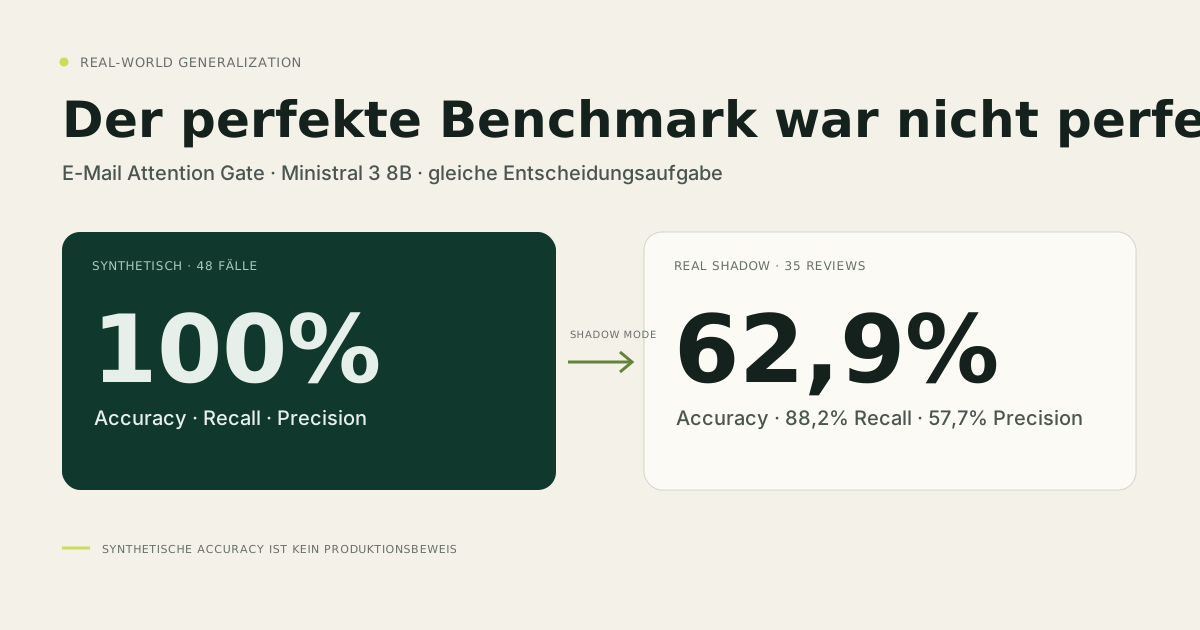 Der reale Shadow-Test relativierte den perfekten synthetischen Benchmark deutlich.
100 % im Benchmark wurden zu 62,9 % mit echten Daten
Ich ließ denselben Ansatz im Shadow Mode gegen manuell bewertete reale E-Mails laufen. Im Shadow Mode wurden die Entscheidungen zur Auswertung mitgeschrieben, ohne daraus automatische Aktionen auszulösen. Auf 35 deduplizierten Reviews ergab sich:
| Metrik | Ergebnis |
|---|---|
| Accuracy | 62,86 % |
| NEEDS_ACTION Recall | 88,24 % |
| NEEDS_ACTION Precision | 57,69 % |
| True Positives | 15 |
| False Negatives | 2 |
| False Positives | 11 |
| True Negatives | 7 |
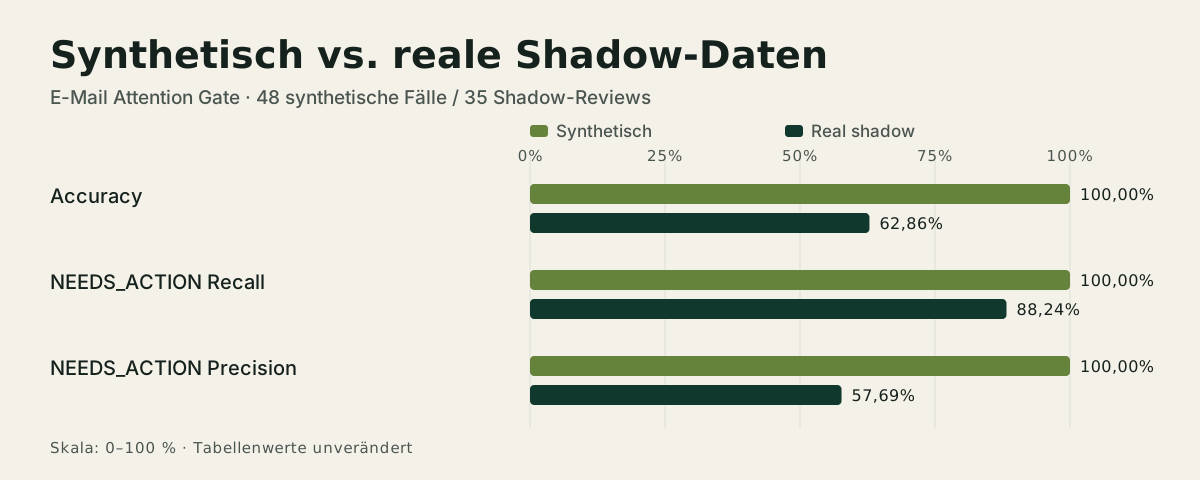 Synthetische und reale Shadow-Metriken im Vergleich.
Aus einem scheinbar perfekten Classifier war ein System mit nur 62,9 Prozent Accuracy geworden.
Wäre ich nach dem synthetischen Benchmark stehen geblieben, hätte ich die Produktionsqualität massiv überschätzt.
Das ist für mich eine der wichtigsten Lektionen dieser Experimente und passt direkt zu meinem Grundsatz bei AI-Agent-Evaluation: Offline-Evals sind nötig, aber reale Shadow-Daten entscheiden, ob ein Gate außerhalb des Labors trägt.
Manche Classification-Probleme sind eigentlich State-Probleme
Die häufigste Fehlerklasse waren optionale Aktionen: Einladungen, Angebote oder Aktivitäten, die der Empfänger tun könnte, aber nicht tun muss.
Teilweise fehlte dem Modell dafür schlicht Information:
- Hat der Benutzer bereits reagiert?
- Ist diese Einladung relevant?
- Wurde die Aufgabe schon erledigt?
- Existiert bereits ein Kalendertermin?
- Wurde das Thema in einem anderen System abgeschlossen?
Damit wird aus einem scheinbaren Classification-Problem ein State-Problem.
Kein besserer Prompt kann Information rekonstruieren, die das Modell nicht besitzt.
Phishing zeigte die nächste Grenze lokaler Jev-Alternativen
Ich habe außerdem getestet, ob kleine lokale Modelle als Phishing Gate funktionieren.
| Experiment | Recall | Precision |
|---|---|---|
| Ministral 8B, 3 Klassen | 44,4 % | 80,0 % |
| Binary Phishing Gate | 55,6 % | 71,4 % |
| + Structural Signals | 72,2 % | 72,2 % |
| Challenge Set, LLM only | 33,3 % | 100 % |
| Challenge Set + Signals | 41,7 % | 71,4 % |
| Naive Hard Gate | 50,0 % | 46,2 % |
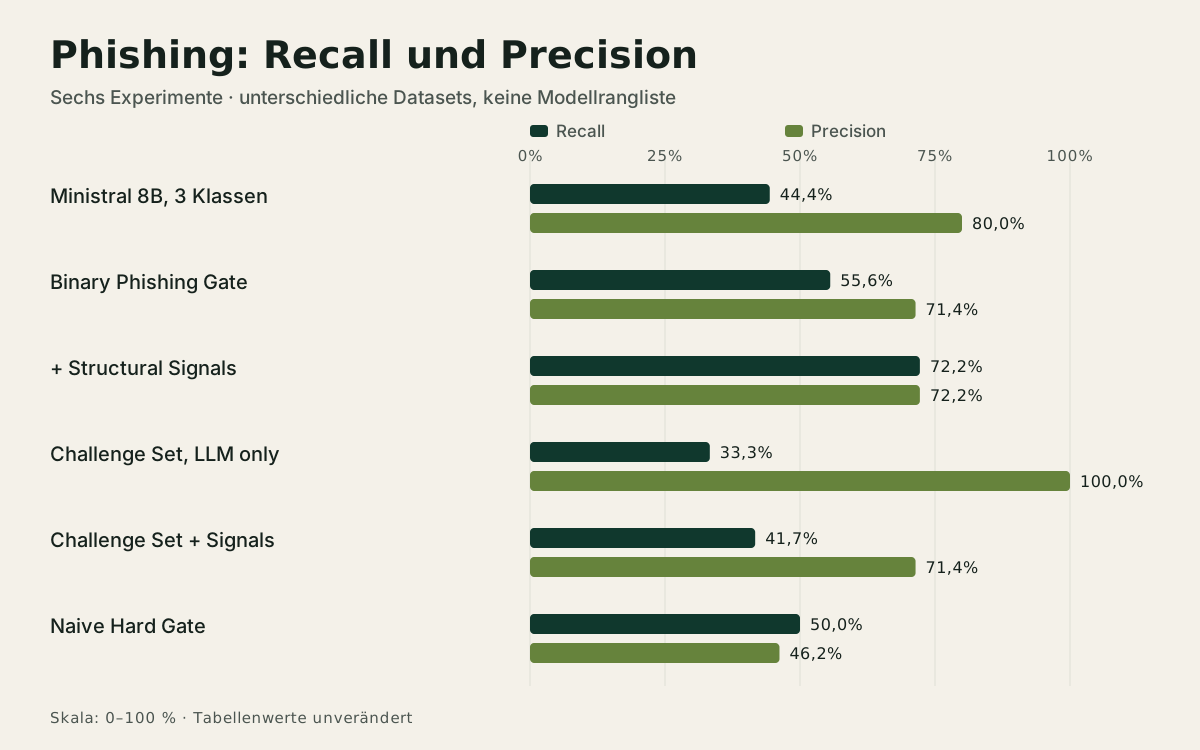 Recall und Precision der sechs Phishing-Experimente.
Ich ergänzte zunächst strukturelle Signale wie einen From-/Reply-To-Domain-Mismatch. Im ersten Dataset half das.
Dann habe ich den Benchmark bewusst schwieriger gemacht. Das Challenge Set enthielt legitime Newsletter, CRM-Mails, Support- und Transaktionsmails mit unterschiedlichen Reply-To-Domains. Die Qualität brach ein. Auch ein größeres 14B-Modell löste das Grundproblem nicht.
Für den nächsten Versuch hätte ich zuerst die verfügbare Evidenz verbessert: Ein größeres Modell hatte die Schwächen im Challenge Set nicht behoben.
Für eine ernsthafte Phishing-Entscheidung wären beispielsweise SPF, DKIM, DMARC, Domain- und URL-Reputation, Redirect-Analyse, Threat Intelligence oder Attachment-Analyse relevant.
Ein Modell kann solche Informationen interpretieren. Es kann sie nicht erfinden.
Mehr Modell ist kein Ersatz für fehlende Signale.
Die beste lokale Jev-Alternative war deshalb kein einzelnes Modell
Aus den Tests ergibt sich für mich eine bessere Architektur: ein Fast Decision Layer.
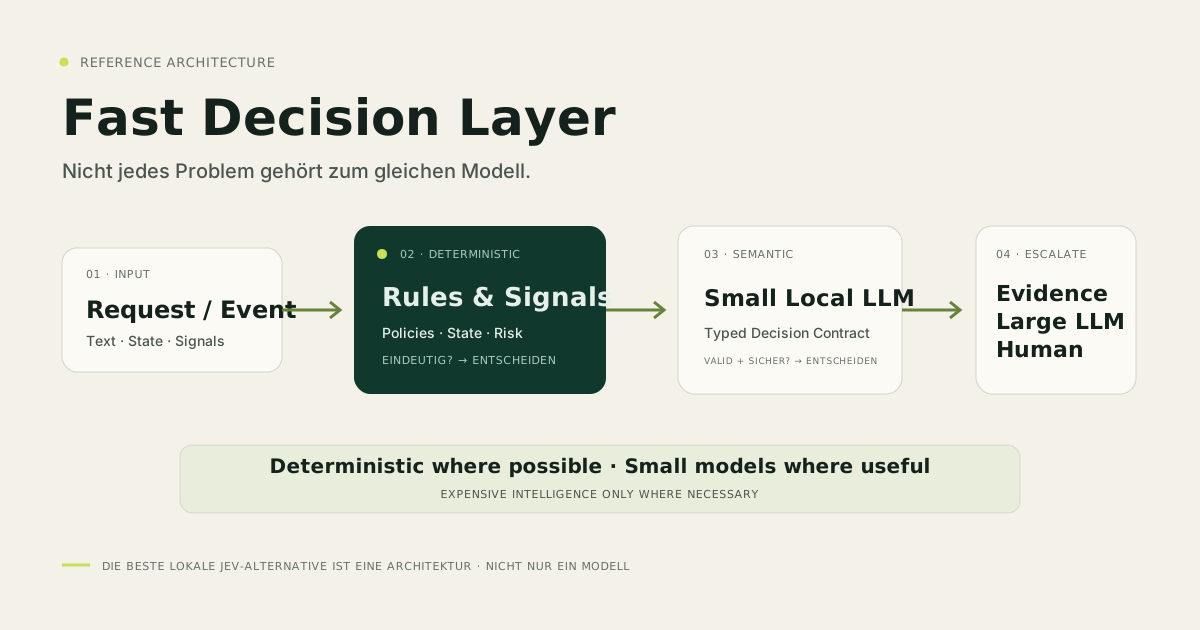 Deterministische Entscheidungen zuerst, kleines lokales LLM für semantische Ambiguität und Eskalation für komplexe Fälle.
1. Deterministische Regeln zuerst
Wenn eine Entscheidung zuverlässig durch Code getroffen werden kann, sollte kein LLM beteiligt sein.
Dazu gehören bekannte Zustände, harte Policies, Grenzwerte, strukturierte Flags und eindeutige Security-Signale.
2. Kleines lokales LLM für semantische Ambiguität
Für Intent Routing, Relevanz, Priorisierung oder die Auswahl aus wenigen bekannten Aktionen kann ein gutes 8B- oder 9B-Modell interessant sein.
3. Eskalation für schwierige Fälle
Wenn zusätzliche Evidenz oder tieferes Reasoning nötig ist, eskaliert der Layer an ein größeres LLM, Web Search, Retrieval, Spezial-APIs, Code Execution oder Human Review.
Die Grundidee lautet:
Deterministic where possible. Small models where useful. Expensive intelligence only where necessary.
Ist Ministral 8B damit eine lokale Jev-Alternative?
Für bestimmte Use Cases: ja.
Ministral 3 8B kann bei engen Binary- oder Choice-Entscheidungen lokal eine ähnliche architektonische Rolle übernehmen, vor allem wenn:
- der Entscheidungsraum klein ist,
- die Klassen eindeutig definiert sind,
- die notwendigen Informationen im Input vorhanden sind,
- Fehler begrenzte Konsequenzen haben,
- der Output streng validiert wird,
- ein Fallback existiert,
- reale Shadow-Evals stattfinden.
Es ist aber kein funktionaler 1:1-Ersatz für Jev.
TypeSafe entwickelt Jev speziell für maschinenlesbare Entscheidungen und beschreibt typisierte Entscheidungen, Wahrscheinlichkeiten, Confidence sowie eine auf diese Aufgaben optimierte Modellarchitektur. TypeSafes veröffentlichte Speed-/Cost-/Accuracy-Vergleiche sind Hersteller-Evals; TypeSafe weist selbst auf mögliche Verzerrungen durch die Erstellung der Workflows durch das eigene Model-Capabilities-Team hin. Ich habe diese Claims nicht unabhängig reproduziert.
Spezialisierte Jev-Alternativen: Was ich noch nicht selbst gemessen habe
Neben kleinen generativen LLMs gibt es spezialisierte Modelle für Klassifikation und typisierte Entscheidungen. Die folgenden Angaben stammen aus den verlinkten Projektquellen, geprüft am 4. November 2026. Sie sind keine Ergebnisse meines Benchmarks.
| Kandidat | Ansatz laut Projektquelle | Offene Frage für meinen Einsatz |
|---|---|---|
| Tev1 | Jev-inspiriertes Open-Weight-Modell auf Qwen3.5-4B | Trägt die Spezialisierung bei meinen Routing- und Attention-Aufgaben? |
| GLiNER2.5-multi-Decide | Mehrsprachiger Klassifikator mit zur Laufzeit definierten Labels | Wie zuverlässig arbeitet er mit deutschen Geschäftstexten? |
| Span-02 | Decision-Modell mit offenen Gewichten und begrenzbarem Reasoning-Budget | Passen Laufzeit und Betriebsanforderungen zu meinem lokalen Aufbau? |
Tev1 kennzeichnet seine dokumentierten Evaluationsläufe als wiederverwendete Entwicklungsbenchmarks. Das Repository warnt außerdem: Token-Logprobs sind Modellpräferenzen, keine kalibrierte Konfidenz.
Fastino empfiehlt die mehrsprachige Variante für nicht englische Eingaben. Die veröffentlichte Benchmark-Suite ist jedoch englischsprachig. Daraus lässt sich keine gemessene Qualität auf deutschen E-Mails ableiten.
Der Jev-Alternativen-Artikel von Respan liefert weitere Kandidaten. Respan entwickelt selbst Span-Modelle, setzt im beschriebenen Vergleich Span-01 als Judge ein und bezieht zusätzliche Ergebnisse aus anderen Benchmarks. Ich behandle diese Werte als Anbieter-Evaluationen und übernehme sie nicht in meine lokale Ergebnistabelle.
Wann wäre ein zusätzlicher Vergleich sinnvoll?
Wenn er eine konkrete Architekturentscheidung klärt: Kann ein Spezialmodell bei derselben Aufgabe mehr Fälle zuverlässig automatisieren als Regeln oder mein kleines LLM?
Dafür würde ich identische Eingaben und Klassen verwenden, Anpassungen von einem frischen Testset trennen und Fehler je Klasse auswerten. Entscheidend wären neben Latenz und Genauigkeit die Automatisierungsquote bei einer vorher festgelegten maximalen Fehlerquote sowie der Aufwand für Betrieb und Fallbacks. Ein Confidence-Schwellenwert müsste an separaten Daten geprüft werden; eine hohe ausgegebene Zahl genügt nicht.
Warum lokale Jev-Alternativen trotzdem interessant sind
Lokale Modelle bieten andere Vorteile:
- Daten bleiben in der eigenen Infrastruktur,
- keine externe API für jede Entscheidung,
- vorhersehbare lokale Inferenzkosten,
- Offline-Betrieb,
- geringere Provider-Abhängigkeit,
- eigene Decision Contracts,
- Kontrolle über Modell und Runtime,
- Integration in private oder On-Premise-Systeme.
Für Unternehmen mit Anforderungen an Datenhoheit und lokale Verarbeitung kann das wichtiger sein als die absolut niedrigste Benchmark-Latenz. Das ist auch der Grund, warum ich bei Private AI vs. Public Cloud nicht nur Modellqualität, sondern das gesamte Betriebsmodell betrachte.
Was ich aus den Tests mitgenommen habe
- Kleine lokale LLMs können schnelle Entscheidungen treffen. Sub-200-ms-Latenzen waren lokal möglich.
- Sehr kleine Modelle waren häufig qualitativ zu schwach. 1B bis 4B waren nicht automatisch ausreichend.
- Größer ist ebenfalls nicht automatisch besser.
- Structured Output garantiert keine Decision Quality.
- Der Decision Contract ist ein wesentlicher Teil des Systems.
- Synthetische Benchmarks können massiv zu optimistisch sein. Mein deutlichstes Beispiel: 100 % offline → 62,9 % im realen Shadow-Test.
- Fehlender State lässt sich nicht wegprompten.
- Fehlende Evidenz lässt sich nicht wegprompten.
- Rules, kleine LLMs und große Modelle gehören in unterschiedliche Ebenen derselben Architektur.
Fazit: Welche lokale Jev-Alternative würde ich heute wählen?
Ich würde nicht nach einem universellen Jev-Ersatz suchen.
Ich würde einen lokalen Fast Decision Layer bauen.
Für eindeutige Entscheidungen: Rules und Code.
Für enge semantische Entscheidungen: ein gutes kleines lokales Modell mit strengem Decision Contract.
Für komplexe oder unsichere Entscheidungen: größeres Modell, externe Evidenz, Tools oder einen Menschen.
Unter den von mir getesteten Modellen war Ministral 3 8B Instruct der überzeugendste Ausgangspunkt für schnelle typisierte Entscheidungen. Mehrere kleinere Modelle waren schneller, qualitativ aber nicht gut genug. Der Qwen-3.5-9B-Lauf mit verändertem Contract war beim Routing deutlich erfolgreicher; wie viel davon auf das Modell oder den Contract zurückgeht, bleibt offen.
Für die Architekturentscheidung würde ich deshalb jede Aufgabe getrennt prüfen: Welche Fälle lassen sich mit Regeln lösen, wo genügt ein kleines Modell und wann ist eine Eskalation erforderlich?
Genau darin liegt für mich das Potenzial lokaler Jev-Alternativen.
Häufige Fragen zu lokalen Jev-Alternativen
Was ist eine lokale Alternative zu Jev?
Für eng begrenzte Entscheidungen kann ein kleines lokales Open-Weight-LLM mit Structured Output und einem klaren Decision Contract eine ähnliche Rolle im System übernehmen. Jev bleibt ein spezialisiertes Decision Model und ist funktional nicht identisch.
Welches lokale Modell war in meinem Test am besten?
Ministral 3 8B Instruct in 4-bit erreichte im ersten 24-Fall-Screening 87,5 Prozent Exact Match bei 166 Millisekunden p50-Latenz und war damit mein stärkster Speed/Quality-Kandidat.
Reicht ein 1B- oder 4B-Modell?
Für meine getesteten Decision Gates meistens nicht. Die sehr kleinen Modelle waren schnell, aber qualitativ deutlich schwächer.
Ist Structured Output genug?
Nein. Ein valides JSON-Schema stellt die Form sicher, nicht die fachliche Richtigkeit der Entscheidung.
Warum ist Shadow Mode wichtig?
Weil synthetische Gold Sets reale Verteilung, State und Ambiguität leicht unterschätzen. Mein E-Mail-Gate fiel von 100 Prozent synthetischer Accuracy auf 62,9 Prozent auf realen Shadow-Daten.
Wie sieht ein sinnvoller lokaler Fast Decision Layer aus?
Deterministische Regeln zuerst, ein kleines lokales Modell für eng begrenzte semantische Entscheidungen und eine Eskalationsstufe für komplexe oder evidenzabhängige Fälle.