Jev erklärt: Warum KI-Anwendungen nicht für jede Entscheidung ein LLM brauchen
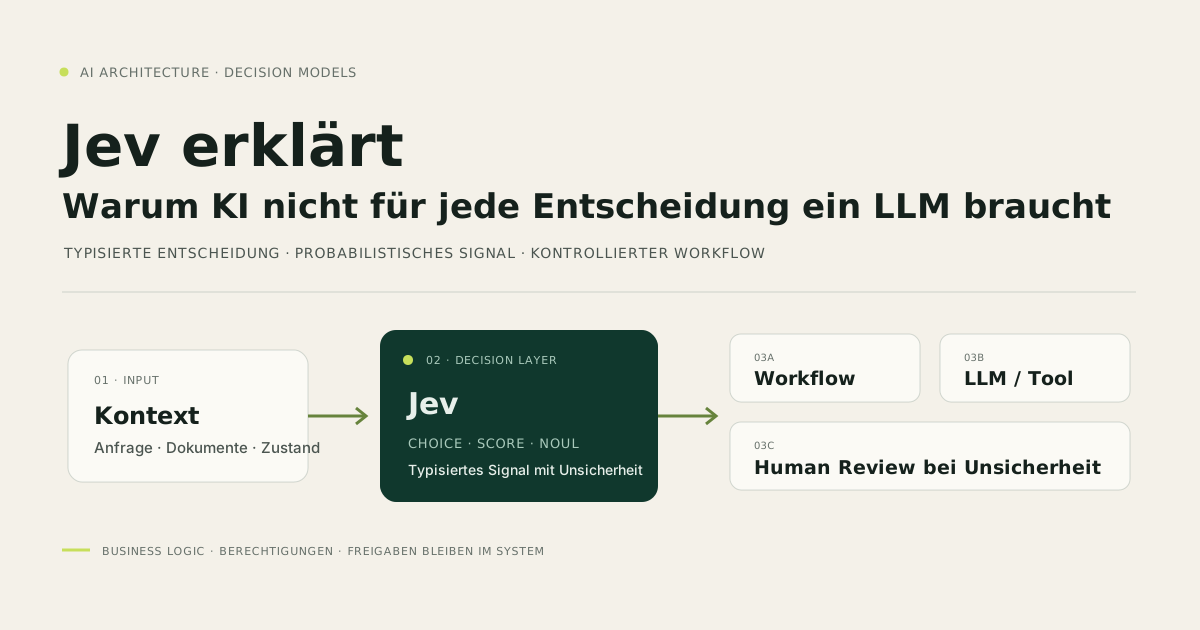
Kurzantwort: Jev ist ein Decision Model von TypeSafe AI, das Software mit typisierten, probabilistischen Antworten statt mit frei generiertem Text versorgen soll. Es ist interessant, wenn eine Anwendung zwischen bekannten Optionen wählen, etwas bewerten oder eine Prüfung auslösen muss. Jev ersetzt kein generatives LLM: Es kann eine eigene Entscheidungsschicht in einem System mit LLMs, Regeln und menschlicher Freigabe bilden.
Die zentrale Architekturfrage lautet nicht „Welches Modell ist am besten?“, sondern: Welche Teile einer KI-Anwendung brauchen Sprache – und welche brauchen eine klar begrenzte Entscheidung?
Was ist Jev?
Jev ist TypeSafe AIs erstes öffentlich vorgestelltes „System One Model“. TypeSafe beschreibt System-One-Modelle als eine Modellklasse für schnelle, strukturierte Entscheidungen, die Software direkt verwenden kann. Die öffentliche API nimmt einen Zustand beziehungsweise Kontext und typisierte Fragen entgegen. Die Antworten folgen einem vorgegebenen Schema.
Jev wird von TypeSafe AI entwickelt. Der Gründer Diogo Almeida stellte das Modell in TypeSafes Launch-Beitrag vor. Die Begriffe „System One“ und die Beschreibung als Modellklasse sind die Einordnung des Anbieters, keine etablierte unabhängige Modellkategorie.
Die dokumentierten Fragetypen umfassen Choice für die Auswahl aus Optionen, Score für eine Bewertung und Noul für eine Ja-Nein-Frage mit Wahrscheinlichkeit. Damit kann eine Anwendung beispielsweise fragen, welches Support-Team zuständig ist, wie gut ein Dokument zu einer Anforderung passt oder ob ein Vorgang menschlich geprüft werden sollte. Die TypeSafe API-Dokumentation beschreibt diese Schnittstelle; die Einführung von System One und Jev ist TypeSafes eigene Einordnung.
Das macht Jev nicht zu einer klassischen Regel-Engine. Der Kontext kann weiterhin unstrukturierten Text enthalten; die Entscheidung, die zurückkommt, ist jedoch an eine definierte Form gebunden. Der relevante Unterschied zu einem LLM liegt also vor allem im Ausgabevertrag: eine maschinenlesbare Entscheidung statt einer primär für Menschen formulierten Antwort.
Was kann Jev entscheiden?
Aus den Typen Choice, Score und Noul lassen sich mehrere typische Softwareentscheidungen formulieren:
- Auswahl und Routing: Welche Queue, welches Modell oder welches Tool passt zu diesem Fall?
- Klassifikation: Zu welcher vorgegebenen Kategorie gehört ein Dokument oder eine Anfrage?
- Score und Eignung: Wie gut erfüllt ein Beleg eine definierte Anforderung oder Rubrik?
- Wahrscheinlichkeit: Wie wahrscheinlich ist es, dass ein Fall eine Bedingung erfüllt?
- Review-Gate: Reicht die Evidenz für eine automatische Weiterverarbeitung oder soll ein Mensch prüfen?
Die Typisierung begrenzt die Form der Antwort. Sie beweist nicht, dass die fachliche Einschätzung richtig ist. Auch eine syntaktisch gültige Auswahl kann falsch sein; Wahrscheinlichkeiten müssen auf dem konkreten Anwendungsfall kalibriert und gegen reale Fälle evaluiert werden. TypeSafe bewirbt Wahrscheinlichkeiten als kalibriert. Das ist zunächst ein Hersteller-Claim, kein Ersatz für eine eigene Validierung.
Performance, Kosten und Zuverlässigkeit: Claims einordnen
TypeSafes Launch-Beitrag vom 15. September 2026 nennt für Jev 70–500 Millisekunden Latenz, einen Inputpreis von 0,042 US-Dollar pro Million Tokens und kostenloses Output-Token-Volumen. Das sind zeitgebundene Herstellerangaben, keine unabhängigen Messwerte für eine beliebige Produktionslast. TypeSafe weist im selben Beitrag auf Grenzen und mögliche Verzerrungen der eigenen Vergleiche hin. Preise und Zugriff sollten vor einer Entscheidung aktuell geprüft werden.
Auch „typ-sicher“ bedeutet nicht „fachlich korrekt“: Das Antwortschema kann eine ungültige Ausgabeform verhindern. Ob die gewählte Option, der Score oder die Wahrscheinlichkeit stimmt, muss mit eigenen Daten und Fehlerkosten evaluiert werden.
Warum ein eigener Decision Layer architektonisch interessant ist
Ein verbreitetes Muster lässt ein LLM freien Text erzeugen, verlangt darin JSON, parst die Antwort, prüft das Schema und wiederholt den Aufruf bei ungültiger Ausgabe. Das kann funktionieren, verbindet aber zwei Aufgaben: Das Modell muss erst eine fachliche Entscheidung treffen und dann die verlangte Ausgabeform exakt einhalten. Retries beheben Formatfehler; sie machen eine falsche Entscheidung nicht korrekt.
Ein Decision Model kann diese Schnittstelle vereinfachen, wenn die Frage tatsächlich auf bekannte Antworttypen begrenzt ist. Die Anwendung definiert weiterhin Optionen, Schwellen, Zuständigkeiten und Konsequenzen. Das Modell liefert ein Signal; normaler Code setzt Regeln durch und kontrolliert Seiteneffekte. So bleibt ein Decision Layer eine abgegrenzte Komponente und wird nicht mit der gesamten Business-Logik verwechselt.
Ein Decision Layer zwischen Kontext und Aktion
- 01
Input
Anfrage, Dokumente und erlaubter Kontext
- 02
Decision Layer · Jev
Choice, Score oder Wahrscheinlichkeit
- 03
Business Logic
Schwellen, Berechtigungen und Validierung
- 04
LLM oder Tool
Text generieren oder freigegebene Aktion ausführen
- 05
Human Review
Unsichere oder folgenreiche Fälle prüfen
Bedeutung für Agenten, Workflows und Guardrails
Ein Agent muss nicht jede interne Verzweigung durch freie Textgenerierung lösen. Eine abgegrenzte Entscheidung kann bestimmen, ob ein Support-Agent eine Wissenssuche oder eine Übergabe startet, welches Tool für einen Schritt infrage kommt oder ob ein Ergebnis vor der Aktion einen Review-Schritt benötigt.
Das passt zu einer kontrollierten Agent-Architektur: Tool-Aufrufe bleiben durch Code begrenzt, Berechtigungen werden außerhalb des Modells geprüft und Aktionen mit Folgen erhalten eine explizite Freigabe. Mehr zur Abgrenzung von Agenten und festen Prozesspfaden erklärt KI-Agent vs. Workflow vs. Automation.
In RAG kann eine Entscheidung nach dem Retrieval prüfen, ob die gefundenen Belege relevant oder ausreichend erscheinen. Sie sollte keine Berechtigungsprüfung ersetzen und keine fehlende Evidenz in eine sichere Antwort verwandeln. Für belastbare Systeme gehören solche Gates in eine Evaluationsschleife, wie im Beitrag RAG Evaluation: Metriken, Golden Dataset und Regression Tests.
Jev vs. LLM: unterschiedliche Aufgaben, kombinierbar
Ein generatives LLM ist stark, wenn eine Aufgabe Sprache verlangt: erklären, zusammenfassen, formulieren, übersetzen oder flexibel mit einem Menschen interagieren. Jev ist laut TypeSafe für strukturierte, typisierte Entscheidungen gedacht. Für ein konkretes Produkt kann die sinnvolle Architektur beide Komponenten enthalten.
| Aufgabe | Jev als Decision Model | Generatives LLM |
|---|---|---|
| Aus vorgegebenen Support-Queues wählen | Passende Form: Choice | Möglich, aber freie Ausgabe muss begrenzt und validiert werden |
| Evidenz nach einer Rubrik bewerten | Choice oder Score als prüfbares Signal | Kann zusätzlich begründen oder Textstellen zusammenfassen |
| Antwort an Mitarbeitende formulieren | Nicht der vorgesehene Schwerpunkt | Geeignet für natürliche Sprache |
| Unbekannte Optionen offen erkunden | Begrenzte Auswahl passt nur bedingt | Flexiblere Exploration und Erklärung |
| Eine folgenreiche Aktion ausführen | Entscheidung kann Routing-Signal sein | Modell kann planen; Ausführung bleibt kontrolliertem Code vorbehalten |
Ein mögliches Muster ist: Jev klassifiziert eine Anfrage und gibt eine Konfidenz beziehungsweise Wahrscheinlichkeitsverteilung zurück; Anwendungscode routet sichere Fälle; ein LLM formuliert die Antwort; niedrige Konfidenz führt in eine menschliche Prüfung. Welcher Schritt welches Modell braucht, muss der Use Case entscheiden.
Jev vs. klassische Klassifikatoren und Regeln
Klassifikation gibt es lange vor Jev. Wenn Kategorien stabil sind, gelabelte Beispieldaten vorhanden sind und ein kleines Modell die nötige Qualität erreicht, kann ein klassischer Klassifikator die einfachere, lokal betreibbare Lösung sein. Wenn ein Prozess exakt formulierbare Bedingungen hat, sind Regeln oft besser: Sie sind deterministisch, transparent und leicht zu testen.
Jevs interessanter Beitrag ist daher nicht die Erfindung der Klassifikation. TypeSafe produktisiert probabilistische Softwareentscheidungen als eigene Primitive mit einem API-Vertrag für Auswahl, Score und Wahrscheinlichkeit. Ob diese Abstraktion gegenüber einem Klassifikator, einem LLM mit strukturiertem Output oder einer Regel die bessere Wahl ist, hängt von Qualität, Latenz, Betrieb, Datenschutz und Wartungsaufwand ab.
| Typische Aufgabe | Regeln | Jev | LLM |
|---|---|---|---|
| Exakter Grenzwert oder Prozessregel | Meist passend | Unnötig, wenn Bedingung deterministisch ist | Meist unnötig |
| Semantische Zuordnung mit begrenzten Optionen | Starr, sofern Regeln nicht ausreichen | Als Decision Model prüfen | Möglich, wenn zugleich Erklärung oder Text nötig ist |
| Freie Zusammenfassung oder Antwort | Nicht geeignet | Nicht der Zweck | Passend |
| Hohe Nachvollziehbarkeit und lokaler Betrieb | Stark | Hosting- und Vertragsmodell prüfen | Abhängig von Modell und Hosting |
Konkrete Use Cases in AI-Architekturen
Agent Routing und Tool Selection
Ein Intake-Schritt ordnet eine Anfrage etwa den Bereichen „Recherche“, „CRM“ oder „menschliche Übergabe“ zu. Die Anwendung gibt nur erlaubte Optionen vor. Der Agent darf anschließend ausschließlich Tools verwenden, für die sein Kontext und seine Berechtigungen freigegeben sind. Eine Modellentscheidung darf keine Autorisierung erteilen.
RAG Evidence Gate
Nach der Suche kann ein Gate prüfen, ob die Treffer zur Frage passen oder ob die Mindestanforderung an Belege erfüllt scheint. Bei schwacher Evidenz wird neu gesucht, „keine belastbare Antwort“ ausgegeben oder ein Mensch hinzugezogen. Das Gate muss gegen Fälle mit veralteten, widersprüchlichen und irrelevanten Dokumenten getestet werden. Retrieval-Relevanz ist außerdem nicht dasselbe wie fachliche Richtigkeit.
Dokumenten- und Belegprüfung
Bei einer Rechnung kann ein System einzelne Felder oder Belege auf Plausibilität bewerten und Abweichungen markieren. Eine automatische Buchung sollte zusätzlich Betragsgrenzen, Lieferantenstammdaten, Berechtigungen und Freigabevorgaben deterministisch prüfen. Für hohe Beträge oder unklare Belege bleibt ein Review-Gate sinnvoll.
Human Review und Risk Scoring
Ein Score kann Fälle nach einer festgelegten Rubrik priorisieren. Die Anwendung legt fest, welche Bereiche automatisch weiterlaufen dürfen und ab wann ein Mensch prüft. Das ist eine technische Routinghilfe; bei Entscheidungen über Menschen, Zugang oder Rechte braucht es zusätzlich eine fachliche, rechtliche und organisatorische Bewertung.
Entscheidungssignal im RAG-Workflow
- 01
Wurde passende Evidenz abgerufen?
Nein / unklar
Retrieval wiederholen oder Antwort zurückhalten
Ja
Evidenz gegen die Aufgabe bewerten
- 02
Erfüllt die Evidenz die definierte Mindestanforderung?
Unter Schwelle
Human Review oder sichere Enthaltung
Über Schwelle
LLM formuliert mit Quellen; Code prüft Policy
Grenzen, Datenschutz und Sovereign AI
Jev wird über TypeSafes API als gehosteter Dienst angeboten. Bei einem externen Decision Service verlassen Kontextdaten die eigene Laufzeitumgebung. Vor einem Einsatz mit Unternehmensdaten sind deshalb dieselben Fragen zu klären wie bei anderen Cloud-Modellen: Welche Daten werden übertragen? Wo werden sie verarbeitet und gespeichert? Wie lange bleiben Eingaben erhalten? Welche vertraglichen Regelungen gelten für Auftragsverarbeitung, Unterauftragnehmer und Datenübermittlungen?
Die TypeSafe-Einführung nennt ihren damaligen Service- und Evaluationskontext selbst; das ist keine Zusicherung eines EU- oder On-Premise-Betriebs. Aus der verfügbaren Produktbeschreibung lässt sich keine passende Datenresidenz für einen konkreten Unternehmenseinsatz ableiten. Sensible Inhalte sollten erst nach technischer und vertraglicher Prüfung an den Dienst gehen. Der Artikel DSGVO-konforme KI ordnet Datenfluss und Betriebsmodell allgemeiner ein.
Je nach Schutzbedarf können ein lokales kleineres Modell, klassische Klassifikatoren, Regeln oder ein hybrider Aufbau besser passen. Souveränität ist dabei eine Architektur- und Betriebsentscheidung, keine Eigenschaft, die allein aus dem Modelltyp folgt. Siehe auch Private AI vs. Public Cloud.
Betriebsoptionen für eine probabilistische Entscheidung
- Hosted
Gehosteter Decision Service
Typisierte Entscheidung über einen externen API-Aufruf; Datenfluss und Vertrag prüfen.
- Lokal
Lokales Modell oder Klassifikator
Inference in eigener Umgebung; Modellqualität, Betrieb und Updates verantworten.
- Kombinierbar
Regeln und Hybrid
Deterministische Bedingungen im Code, unscharfe Teilaufgaben gezielt mit Modellen ergänzen.
Wann ist Jev sinnvoll – und wann nicht?
Jev ist einen Test wert, wenn eine klar beschreibbare, wiederkehrende Entscheidung zwischen Optionen getroffen werden muss, Regeln zu starr sind und ein generatives Modell dafür unnötig freie Ausgabe produziert. Besonders relevant ist das, wenn ein Entscheidungssignal in einen bestehenden Workflow passt und Unsicherheit kontrolliert zu Review oder Enthaltung führen kann.
Weniger passend ist Jev, wenn die Aufgabe offene Textgenerierung, längere Erklärungen oder kreative Exploration verlangt; wenn eine einfache Regel genügt; oder wenn Daten nicht an einen externen Dienst übermittelt werden dürfen. Auch ein Score ersetzt keine Evaluation, kein Monitoring und keine fachliche Freigabe.
Ein pragmatischer Pilot beginnt mit einer einzelnen Entscheidung und einem repräsentativen, versionierten Testset. Verglichen werden sollten mindestens ein Regelansatz, ein verfügbarer klassischer Klassifikator und ein LLM mit strukturiertem Output, sofern sie für den Anwendungsfall infrage kommen. Gemessen werden fachliche Fehler, Kalibrierung, Eskalationsrate, Latenz, Kosten und Betriebsanforderungen – nicht nur eine Demo.
Häufige Fragen zu Jev
Was ist Jev?
Jev ist TypeSafe AIs erstes öffentlich vorgestelltes System-One-Modell. Es nimmt Kontext und typisierte Fragen entgegen und gibt strukturierte Entscheidungen wie Auswahl, Score oder Ja-Nein-Wahrscheinlichkeit zurück.
Ist Jev ein LLM?
Jev ist kein allgemeines Textgenerierungsmodell. TypeSafe positioniert es als Decision Model für strukturierte, maschinenlesbare Antworten.
Wofür eignet sich Jev besonders?
Jev kann für Routing, Klassifikation, Bewertung und Review-Gates infrage kommen, wenn die Entscheidung begrenzt formulierbar ist. Die Qualität muss für den jeweiligen Use Case evaluiert werden.
Ersetzt Jev klassische LLMs?
Nein. Für freie Sprache und Erklärungen bleibt ein generatives Modell die passendere Komponente. Jev kann eine begrenzte Entscheidung vor oder nach einem LLM übernehmen.
Wie relevant ist Jev für AI Agents?
Es kann definierte Routing-, Klassifikations- oder Review-Entscheidungen liefern. Tool-Berechtigungen und Aktionen müssen weiterhin durch die Anwendung kontrolliert werden.
Ist Jev für sensible Unternehmensdaten geeignet?
Das lässt sich nicht pauschal beantworten. Entscheidend sind Datenfluss, Verarbeitungsort, Aufbewahrung, Vertrag und Schutzbedarf. Für sensible Daten müssen diese Punkte vor dem Einsatz geklärt sein.
Fazit: ein Decision Layer als Muster im AI Stack
Jev macht eine nützliche Architekturidee sichtbar: Nicht jede probabilistische Entscheidung braucht dieselbe Schnittstelle wie ein Chat oder eine Textgenerierung. Typisierte Antworten können Softwarepfade vereinfachen, wenn die möglichen Entscheidungen klar begrenzt sind und die Anwendung Unsicherheit, Berechtigungen und Eskalation selbst kontrolliert.
Das ist kein Ersatz für LLMs, Regeln oder klassische Klassifikatoren. Es ist ein neues Produktmuster für den AI Stack, das gegen diese Alternativen im eigenen Kontext evaluiert werden sollte. Der architektonische Mehrwert entsteht erst, wenn die Entscheidung klein genug, die Folgen kontrolliert und Qualität wie Datenschutz überprüfbar sind.