RAG-System entwickeln: Architektur, Retrieval, Evaluation & Betrieb
Ein RAG-System kann in der Demo überzeugend wirken und im Alltag trotzdem regelmäßig die falsche Richtlinie, eine veraltete Vertragsversion oder einen irrelevanten Dokumentabschnitt heranziehen. Dann hilft es wenig, einfach ein größeres Modell einzusetzen oder am Prompt zu drehen.
RAG-Qualität verbessert man am schnellsten, wenn Retrieval, Kontextaufbereitung und Generation getrennt messbar werden. Erst dann sieht man, ob die falsche Antwort durch Suche, Chunking, Rechtefilter, Index-Synchronität oder tatsächlich durch das LLM entsteht.
Dieser Artikel ist deshalb kein weiterer RAG-Grundlagenbeitrag. Er zeigt, wie Sie ein vorhandenes RAG-System systematisch untersuchen, typische Fehler reproduzieren und Verbesserungen gegen ein stabiles Eval-Set testen.
Die RAG-Pipeline in 60 Sekunden
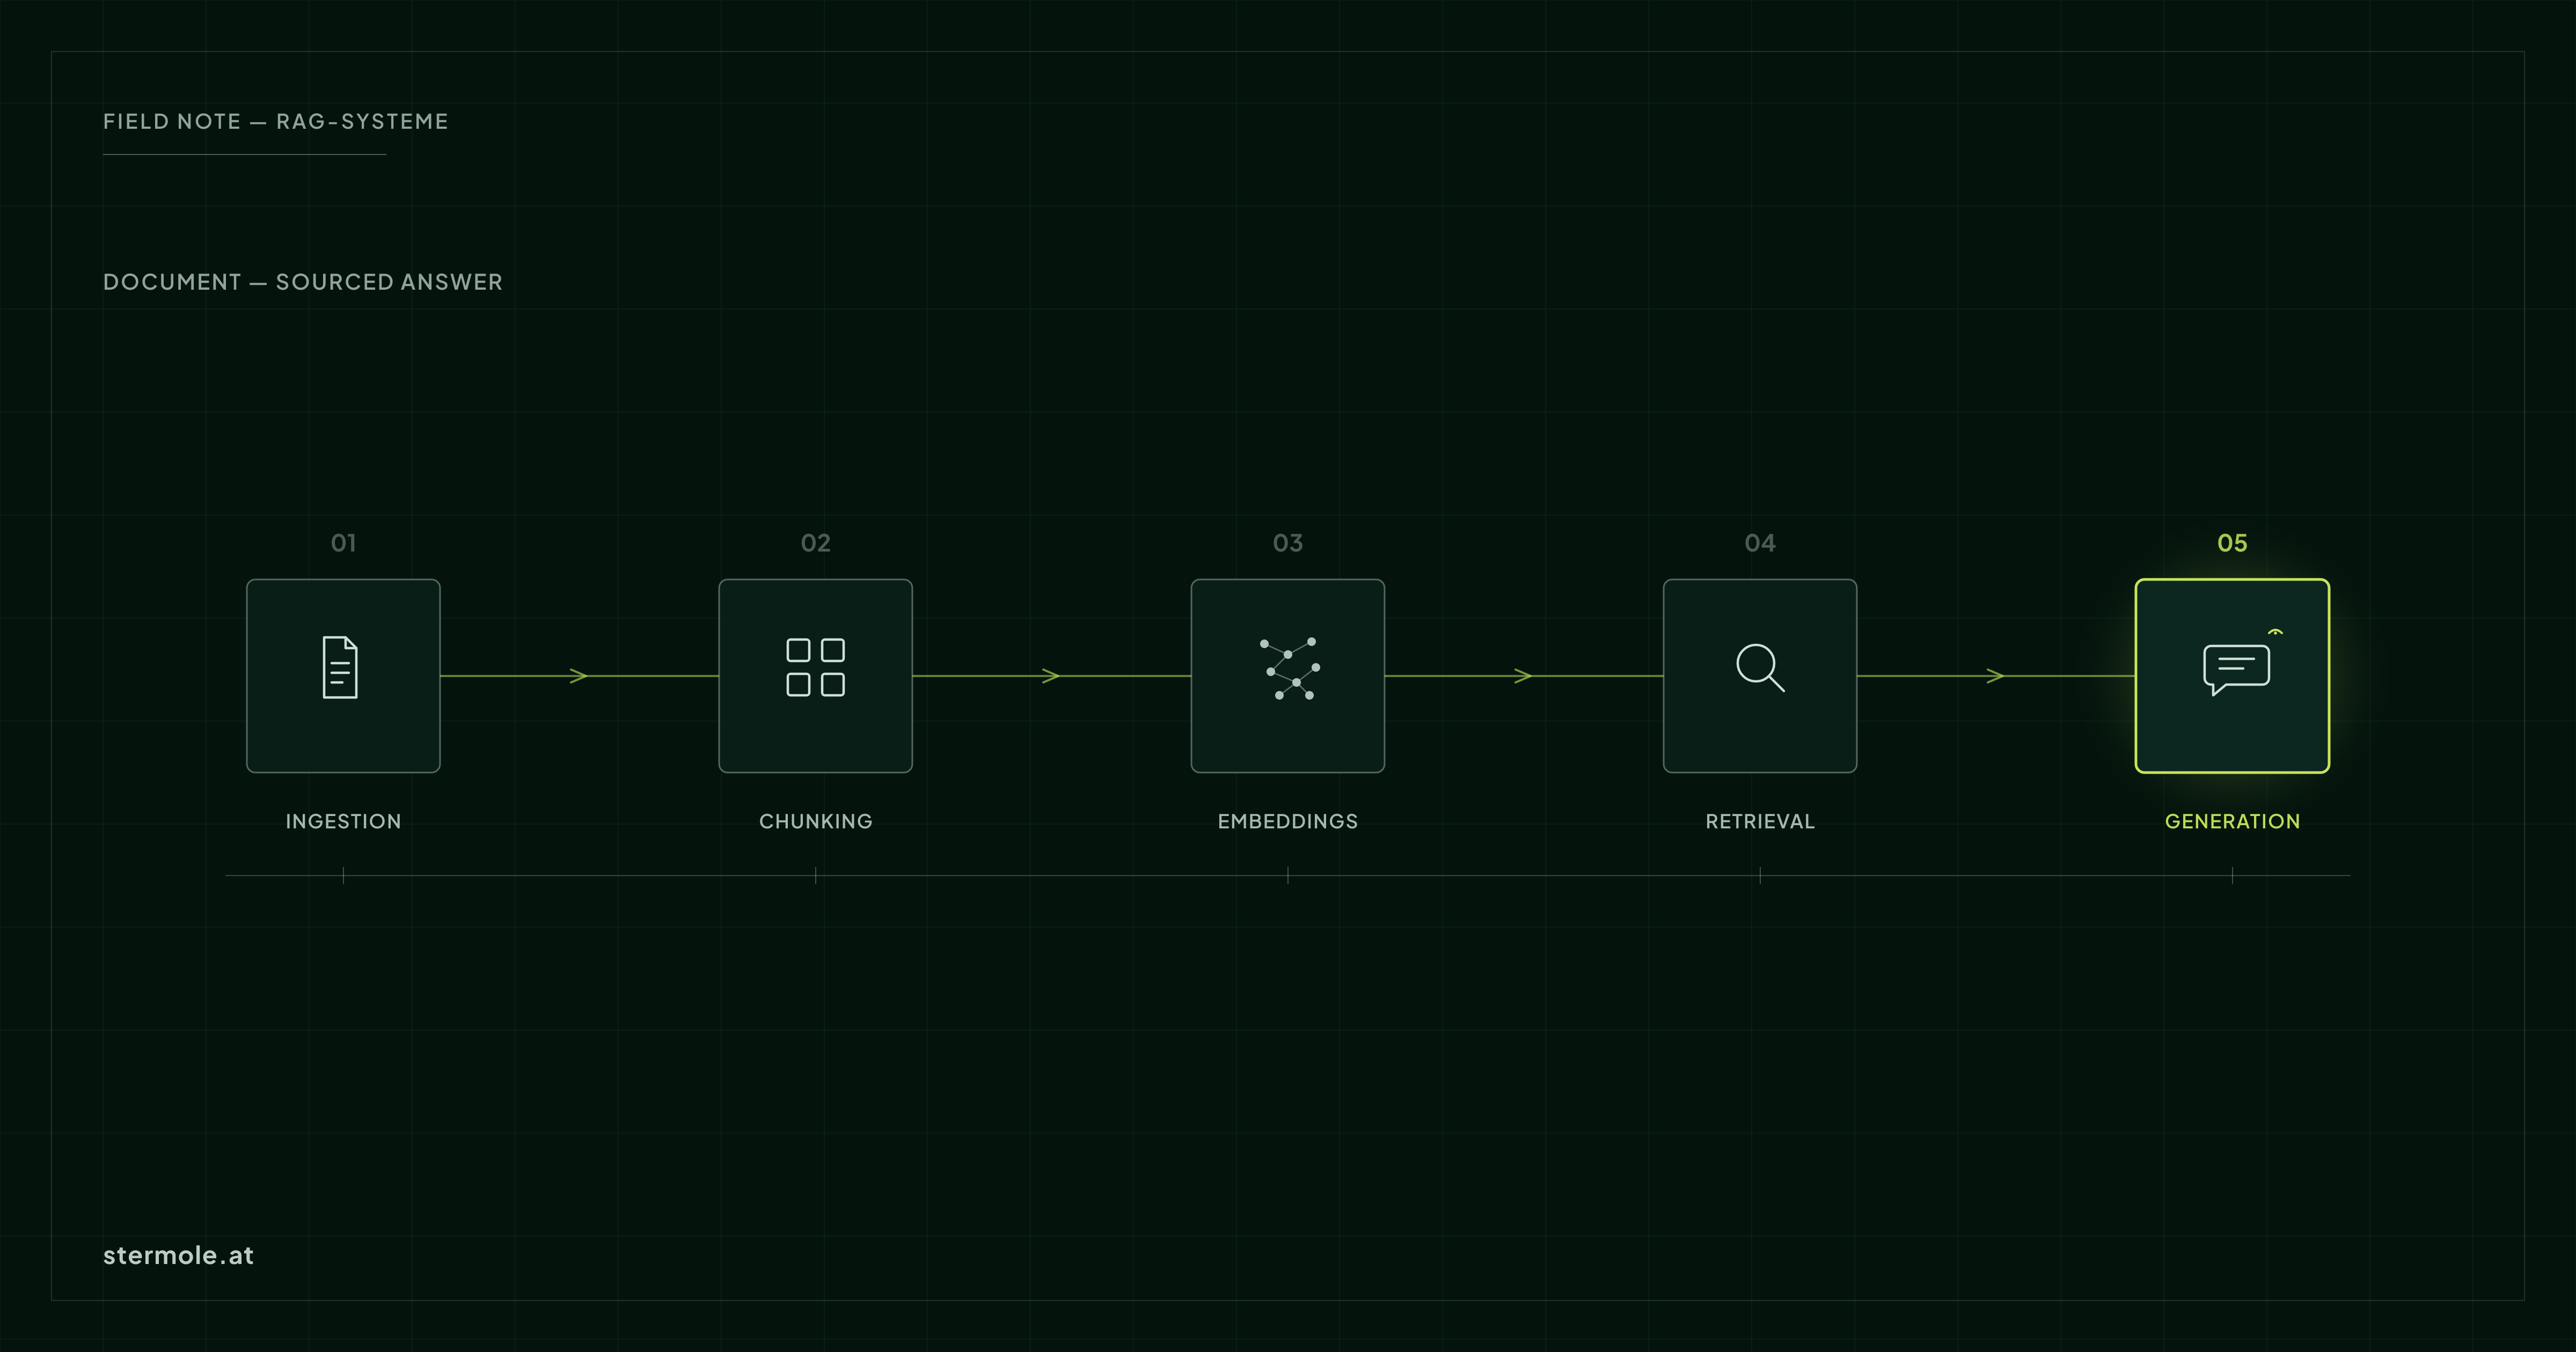
Retrieval-Augmented Generation erweitert ein Sprachmodell zur Laufzeit um Informationen aus eigenen Datenquellen. Vereinfacht besteht die Kette aus fünf Schritten:
- Ingestion – Dokumente, Wikis, Datenbanken oder andere Quellen werden eingelesen.
- Chunking und Aufbereitung – Inhalte werden in abrufbare Einheiten zerlegt und mit Metadaten versehen.
- Indexierung – Embeddings, Keyword-Index oder hybride Suchstrukturen werden aufgebaut.
- Retrieval – zur Nutzerfrage werden passende Dokumente oder Chunks gesucht und gegebenenfalls neu gerankt.
- Generation – das LLM formuliert auf Basis des bereitgestellten Kontexts die Antwort.
Wenn die Antwort falsch ist, kann jeder dieser Schritte die Ursache sein. Genau deshalb ist „das Modell halluziniert“ als Diagnose oft zu grob.
RAG-System entwickeln: die Bausteine, die wirklich zählen
Wenn Sie bei null starten, behandeln Sie RAG zuerst als Informations- und Systemarchitektur – nicht als Modellproblem. Eine produktionsfähige Umsetzung braucht typischerweise diese Ebenen:
- Quellsysteme und Ownership – welche Systeme sind kanonisch?
- Ingestion und Synchronisierung – wie kommen neue, geänderte und gelöschte Objekte ins System?
- Parsing und Normalisierung – bleiben Struktur, Tabellen und Metadaten erhalten?
- Chunking – wie wird Inhalt geteilt, ohne Bedeutung zu zerstören?
- Indexierung – Vector Search, Keyword Search oder Hybrid Search.
- Identität und Berechtigungen – welcher Nutzer darf welche Inhalte überhaupt finden?
- Retrieval und Reranking – wie kommt die richtige Evidenz nach oben?
- Context Assembly – wie viel Kontext erhält das Modell und in welcher Form?
- Generation und Quellenbezug – kann der Nutzer die Antwort am Original überprüfen?
- Evaluation und Betrieb – wie werden Qualität, Regressionen, Aktualität, Latenz und Kosten überwacht?
Gerade die ersten drei Ebenen werden häufig unterschätzt. Wenn SharePoint, DMS, ERP, CRM, Datenbanken, Fileshares oder APIs angebunden werden sollen, behandelt der neue Leitfaden RAG-Datenquellen anbinden Synchronisierung, Metadaten, Rechte und Löschlogik im Detail.
Mit echten Fragen beginnen, nicht mit Technologie
Bevor Sie eine Vector Database oder ein Embedding-Modell auswählen, sammeln Sie repräsentative Fragen der späteren Nutzer. Für jede Frage sollten Sie wissen, welche Quelle die richtige Antwort enthält und was eine fachlich brauchbare Antwort leisten muss.
So entsteht schon vor der Implementierung ein kleines Eval-Set. Gleichzeitig zeigt sich früh, ob die vorgesehenen Datenquellen das erwartete Wissen überhaupt enthalten.
Klären, wo RAG endet und Tools beginnen
Nicht jede Unternehmensfrage sollte aus indexiertem Text beantwortet werden. Exakte aktuelle Werte wie Lagerbestand, Kontostand, offene Aufträge oder Systemstatus gehören häufig hinter kontrollierte APIs oder Tools statt in einen Vektorindex.
Eine gute Architektur kann beides kombinieren:
- Retrieval für Richtlinien, Handbücher, Projektwissen und Dokumente,
- strukturierte Tools oder APIs für aktuelle Transaktionsdaten.
Diese Grenze verbessert die Zuverlässigkeit und macht klarer, welches System für welche Antwort verantwortlich ist.
Warum RAG-Systeme trotz guter Modelle schlechte Antworten liefern
Bei einem klassischen Softwarefehler lässt sich meist recht klar sagen, welche Funktion nicht das erwartete Ergebnis liefert. Bei RAG vermischen sich mehrere probabilistische und deterministische Komponenten: Parser, Suchindex, Embeddings, Filter, Ranking, Prompt und Modell.
Eine typische falsche Antwort kann zum Beispiel so entstehen:
- Das richtige Dokument ist im Index, wird aber nicht gefunden.
- Das Dokument wird gefunden, aber der relevante Absatz liegt in einem anderen Chunk.
- Der richtige Chunk erscheint erst auf Rang 12 und wird nicht an das Modell übergeben.
- Ein Rechtefilter entfernt genau die Quelle, die fachlich nötig wäre.
- Eine alte Dokumentversion liegt weiterhin im Index.
- Der Kontext ist korrekt, aber das Modell zieht daraus die falsche Schlussfolgerung.
Wer diese Fälle nicht auseinanderhält, optimiert im Blindflug.
Fehlerklasse 1: Retrieval findet die falschen Dokumente
Die erste Frage bei einer schlechten RAG-Antwort lautet nicht: „Welches Modell verwenden wir?“, sondern: Welche Dokumente hat das System überhaupt gefunden?
Prüfen Sie für eine konkrete Testfrage:
- Welche Dokumente oder Chunks liegen in Top-k?
- Ist die fachlich richtige Quelle überhaupt dabei?
- Auf welchem Rang erscheint sie?
- Welche irrelevanten Treffer verdrängen sie?
- Greifen Metadaten-, Mandanten- oder Rechtefilter wie erwartet?
Wenn die richtige Quelle nicht im Retrieval auftaucht, kann die Generation kaum zuverlässig werden. Dann liegen die Hebel eher bei Query-Aufbereitung, Embeddings, Keyword Search, Hybrid Search, Filtern oder Domänenbegriffen als beim LLM.
Gerade bei Produktnamen, Artikelnummern, Abkürzungen, juristischen Begriffen oder internen Bezeichnungen kann reine semantische Suche schwächer sein als eine Kombination aus semantischer und lexikalischer Suche. Den technischen Vergleich und eine Entscheidungsmatrix finden Sie unter Hybrid Search vs. Vector Search bei RAG.
Fehlerklasse 2: Der relevante Chunk wird nicht gefunden
Ein Dokument kann korrekt gefunden werden und trotzdem die falsche Antwort liefern, wenn der entscheidende Inhalt in einem ungünstig geschnittenen Chunk steckt.
Typische Probleme:
- Überschrift und zugehöriger Absatz wurden getrennt.
- Tabellen verlieren Spalten- oder Zeilenkontext.
- Eine Ausnahme steht im nächsten Chunk und fehlt deshalb.
- Listen werden ohne einleitenden Kontext indexiert.
- Sehr große Chunks verwässern die relevante Passage.
- Sehr kleine Chunks verlieren semantische Zusammenhänge.
Chunking ist deshalb keine einmalige technische Einstellung, sondern Teil der Informationsarchitektur. Gute Grenzen hängen vom Dokumenttyp ab: Verträge, technische Handbücher, Wiki-Seiten und Tabellen brauchen nicht zwingend dieselbe Strategie. Konkrete Varianten und eine Dokumenttyp-Matrix stehen in RAG Chunking: Strategien für Unternehmensdaten.
Fehlerklasse 3: Ranking oder Reranking ist schlecht
Manchmal wird der richtige Inhalt gefunden, aber zu weit hinten einsortiert. Das ist besonders problematisch, wenn nur wenige Treffer an das LLM weitergereicht werden.
Dann sollten Sie nicht nur „wurde gefunden?“ messen, sondern auch wie weit oben relevante Treffer erscheinen. Bei schwierigen Datenbeständen kann ein zweiter Ranking-Schritt sinnvoll sein, der die zunächst gefundenen Kandidaten genauer gegen die Anfrage bewertet.
Entscheidend ist der Vergleich mit echten Fragen: Ein Reranker ist nicht automatisch besser, nur weil er technisch anspruchsvoller ist. Relevant ist, ob er auf Ihrem Eval-Set mehr brauchbaren Kontext in das tatsächlich verwendete Context Window bringt.
Fehlerklasse 4: Parsing oder Chunking zerstört Kontext
Bevor Embeddings und Retrieval überhaupt arbeiten können, muss aus dem Quelldokument verwertbarer Text werden. Besonders PDFs sind häufig problematisch:
- mehrspaltige Layouts werden in falscher Reihenfolge gelesen,
- Header und Footer landen mitten im Inhalt,
- Tabellen werden zu kaum interpretierbaren Textfolgen,
- gescannte Seiten benötigen OCR,
- Fußnoten oder Bildunterschriften werden falsch zugeordnet.
Öffnen Sie bei auffälligen Antworten deshalb den tatsächlich indexierten Text, nicht nur das Original-PDF. Wenn bereits die Ingestion den Inhalt beschädigt, optimiert ein neues Embedding-Modell nur die Suche auf kaputten Daten.
Fehlerklasse 5: Rechtefilter verändern Retrieval
In Unternehmenssystemen darf Retrieval nicht nur relevant, sondern muss auch berechtigt sein. Das macht die Qualitätssicherung schwieriger.
Ein Test mit Administratorrechten kann perfekt funktionieren, während ein realer Nutzer schlechtere Antworten erhält, weil Abteilungs-, Rollen- oder Mandantenfilter Treffer entfernen. Umgekehrt wäre es kritisch, wenn ein Nutzer Inhalte abrufen kann, für die keine Berechtigung besteht.
RAG-Evaluation sollte deshalb Testfälle mit realistischen Identitäten und Rollen enthalten. Prüfen Sie sowohl:
- False Denials: fachlich notwendige Quelle wird durch einen Filter ausgeschlossen.
- Unauthorized Retrieval: eine nicht erlaubte Quelle gelangt in Retrieval oder Kontext.
Diese Trennung ist besonders wichtig, wenn ein System mehrere Mandanten oder vertrauliche Wissensbereiche bedient.
Fehlerklasse 6: Das LLM ignoriert oder interpretiert Quellen falsch
Wenn Retrieval den richtigen Kontext liefert, beginnt die eigentliche Generationsevaluation.
Typische Fehler sind:
- Eine Quelle wird korrekt zitiert, stützt die Aussage aber nicht.
- Das Modell vermischt Informationen aus mehreren Dokumenten falsch.
- Eine Einschränkung oder Ausnahme wird übergangen.
- Das Modell ergänzt plausibel klingendes Wissen, das nicht im Kontext steht.
- Bei widersprüchlichen Quellen wird keine Unsicherheit signalisiert.
Hier helfen klare Antwortregeln, strukturierte Outputs und – vor allem – Testfälle, bei denen die erwartete fachliche Antwort bekannt ist. Je nach Use Case sollte das System auch sauber sagen können: „Die vorhandenen Quellen reichen für eine belastbare Antwort nicht aus.“
Fehlerklasse 7: Index und Quelldaten laufen auseinander
Ein RAG-System kann technisch perfekt arbeiten und trotzdem falsche Informationen liefern, wenn der Index nicht mehr den aktuellen Datenstand abbildet.
Prüfen Sie deshalb:
- Wie werden geänderte Dokumente erkannt?
- Werden gelöschte Dokumente zuverlässig aus dem Index entfernt?
- Können alte und neue Version parallel vorhanden sein?
- Ist nachvollziehbar, wann eine Quelle zuletzt indexiert wurde?
- Was passiert bei fehlgeschlagenen Ingestion-Jobs?
Für produktive Wissenssysteme gehört Index Freshness zur Reliability. Sonst bewertet das Eval-Set nur einen statischen Laborzustand.
Warum „Halluzination“ oft die falsche Diagnose ist
„Halluzination“ beschreibt das sichtbare Symptom: Eine Antwort ist nicht durch die Fakten gedeckt. Für die technische Fehlerbehebung reicht das nicht.
Eine präzisere Failure Analysis fragt:
- War die richtige Information in der Quelle vorhanden?
- War die Quelle korrekt geparst und indexiert?
- Wurde der relevante Chunk gefunden?
- Wurde er hoch genug gerankt und an das Modell übergeben?
- Durfte der Nutzer diesen Inhalt sehen?
- Hat das Modell den vorhandenen Kontext korrekt verwendet?
- Stützt die angegebene Quelle tatsächlich die Antwort?
Erst diese Zerlegung zeigt, wo ein Fix ansetzen muss.
RAG-Qualität messbar machen
Für ein produktionsnahes System braucht es ein repräsentatives Eval-Set. Ein paar Lieblingsfragen des Entwicklungsteams reichen nicht. Wie daraus ein versioniertes Golden Dataset, Retrieval-Metriken und Regressionstests werden, zeigt RAG Evaluation: Metriken, Golden Dataset & Regression Tests.
Golden Questions statt Demo-Prompts
Sammeln Sie reale oder realistische Fragen aus dem späteren Geschäftsprozess. Das Set sollte nicht nur einfache Happy Paths enthalten, sondern auch:
- häufige Standardfragen,
- mehrdeutige Formulierungen,
- Fragen mit ähnlichen Dokumenten,
- Fälle mit veralteten und aktuellen Versionen,
- Fragen, die nicht beantwortbar sein sollen,
- Rollen- und Berechtigungsfälle,
- domänenspezifische Begriffe und Abkürzungen.
Für jeden Fall sollte zumindest feststehen, welche Quelle relevant ist und was eine akzeptable Antwort ausmacht. Je nach Prozess kann eine exakte Musterantwort sinnvoll sein – häufig sind aber Kriterien oder erwartete Kernaussagen robuster.
Retrieval Quality
Retrieval sollte getrennt von der finalen Antwort bewertet werden. Sinnvolle Fragen sind:
- Wird mindestens eine relevante Quelle gefunden?
- Wie hoch wird sie gerankt?
- Enthält der übergebene Kontext die für die Antwort benötigten Fakten?
- Wie viel irrelevanter Kontext wird zusätzlich mitgeschickt?
Welche konkrete Metrik sinnvoll ist, hängt von System und Testset ab. Wichtig ist weniger eine einzelne Zahl als eine stabile Baseline, gegen die Änderungen vergleichbar werden.
Groundedness
Groundedness beantwortet: Ist die Aussage durch den bereitgestellten Kontext gestützt?
Das ist nicht dasselbe wie fachliche Richtigkeit. Eine Antwort kann sauber im Kontext verankert sein, obwohl das Quelldokument selbst veraltet ist. Deshalb müssen Groundedness und Source Freshness getrennt betrachtet werden.
Correctness
Correctness prüft, ob die Antwort fachlich richtig und für die konkrete Frage vollständig genug ist. Dafür braucht es entweder eine belastbare Referenzantwort oder klar definierte Bewertungskriterien.
Citation Accuracy
Eine Quellenangabe ist nur dann wertvoll, wenn sie die konkrete Aussage tatsächlich belegt. Prüfen Sie deshalb nicht nur, ob eine Citation vorhanden ist, sondern ob Dokument, Passage und Aussage zusammenpassen.
Task Success
Für B2B-Systeme ist oft die wichtigste Frage: Kann der Nutzer seine Aufgabe mit der Antwort korrekt erledigen?
Ein Support-Assistent kann sprachlich perfekte Antworten liefern und trotzdem scheitern, wenn der nächste Arbeitsschritt falsch ist. Task Success verbindet deshalb technische Evaluation mit dem eigentlichen Business-Prozess.
Regression Tests
Sobald ein brauchbarer Ausgangszustand existiert, wird das Eval-Set zum Regressionstest. Änderungen an
- Prompt,
- Chunking,
- Embeddings,
- Suchverfahren,
- Reranking,
- Modell,
- Filtern oder
- Datenquellen
sollten gegen dieselben Kernfälle laufen. So wird sichtbar, ob eine Verbesserung in einem Bereich an anderer Stelle neue Fehler erzeugt.
Latenz und Kosten
Qualität allein reicht für Produktion nicht. Ein System kann fachlich hervorragend sein und trotzdem unbrauchbar werden, wenn Retrieval, Reranking und Generation zu langsam oder unverhältnismäßig teuer sind.
Deshalb gehören zumindest End-to-End-Latenz und Kosten pro relevanter Aufgabe in dieselbe Baseline. Nicht als allgemeiner Benchmark, sondern für Ihren Workflow und Ihre Lastannahmen.
Kompakte Troubleshooting-Matrix
| Symptom | Mögliche Ursache | Was zuerst prüfen | | --- | --- | --- | | Richtige Information existiert, Antwort ist trotzdem falsch | falsches Retrieval oder Generation | Top-k-Treffer und tatsächlich übergebenen Kontext ansehen | | Falsches Dokument wird bevorzugt | Embeddings, Keyword-Match, fehlende Filter | Ranking für repräsentative Fragen vergleichen | | Richtiges Dokument, falscher Ausschnitt | Chunking oder Parsing | indexierten Text und Chunk-Grenzen prüfen | | Relevanter Treffer liegt zu weit hinten | Ranking/Reranking | Rang relevanter Chunks im Eval-Set messen | | Antwort nennt eine Quelle, die Aussage steht dort nicht | Generation/Citation Mapping | Aussage gegen zitierte Passage prüfen | | Admin erhält gute, Nutzer schlechte Antworten | Rechte- oder Mandantenfilter | Retrieval mit realen Rollen vergleichen | | Antworten beziehen sich auf alte Regeln | Index nicht aktuell | Versions-, Lösch- und Reindex-Logik prüfen | | Nach Modell-/Prompt-Wechsel treten neue Fehler auf | Regression | identisches Eval-Set vor/nach Änderung ausführen | | Qualität gut, Nutzung trotzdem schlecht | Latenz, Kosten oder Workflow-Fit | End-to-End Task Success, Latenz und Kosten messen |
Technische Erfahrung als Proof: RAG nicht nur als Demo
In der Referenzübersicht ist unter anderem eine für experdoo aufgebaute selbstgehostete KI-Plattform dokumentiert: RAG für internes Wissen, KI-Agents sowie eine mandantenfähige Architektur mit Daten- und Rechte-Trennung. Entscheidend für solche Systeme ist nicht, dass ein Chatfenster plausible Antworten erzeugt, sondern dass Datenzugriff, Retrieval und Systemgrenzen auch unter realen Bedingungen kontrollierbar bleiben.
Wenn sensible Daten oder Hosting-Vorgaben den Lösungsraum bestimmen, ist zusätzlich die Frage relevant, ob Public Cloud, EU Hosting, Private Cloud, On-Premise oder eine Hybridarchitektur sinnvoll ist. Diese Entscheidung behandle ich separat unter Private AI und On-Premise-KI für Unternehmen. Für den grundsätzlichen Datenschutzrahmen hilft außerdem der Artikel DSGVO-konforme KI für Unternehmen.
Wann aus RAG-Troubleshooting Production Readiness wird
Ein einzelner Retrieval-Fix ist noch keine Produktionsfreigabe. Sobald das RAG-System geschäftskritisch wird, sollte die Prüfung den gesamten Einsatz betrachten:
- repräsentatives Eval-Set und klare Freigabekriterien,
- Retrieval, Groundedness und fachliche Korrektheit,
- Berechtigungsgrenzen,
- Regressionen bei Modell-, Prompt- oder Datenänderungen,
- Logging und Failure Analysis,
- Latenz und Kosten,
- bei Agenten zusätzlich Tool Calls, Freigaben und relevante Angriffspfade.
Genau dafür ist die Leistung KI-System testen und produktionsreif machen gedacht. Sie setzt nicht bei der Frage „Was sollen wir bauen?“ an, sondern bei einem bereits vorhandenen PoC, RAG-System, Copilot oder AI Agent, dessen Qualität vor Go-Live belastbar geprüft werden muss.
Ihr RAG-System liefert bereits Antworten, aber Sie können die Qualität nicht zuverlässig erklären oder messen? Dann können wir gezielt mit Retrieval- und Failure-Analyse starten: RAG-System prüfen lassen.