OCR vs. VLM vs. Parser: Welcher Ansatz verarbeitet Dokumente zuverlässig?

Research-Artikel, Stand: 11. Oktober 2026. Diese Analyse wertet öffentlich dokumentierte Ergebnisse und offizielle Modellangaben aus. Sie enthält keine neu durchgeführten eigenen Modelltests. Messwerte bleiben an die jeweilige Benchmark-Version und Auswertung gebunden. Die Modellgeneration vor späterer Veröffentlichung erneut überprüfen.
Kurzantwort: Es gibt keinen universellen OCR-Sieger
Digitale PDFs mit zuverlässig extrahierbarem Text benötigen oft keinen großen Vision-Transformer. Komplexe gescannte Tabellen profitieren möglicherweise von spezialisierten Document-VLMs. Allgemeine multimodale Modelle können zusätzlich Rechnungsfelder interpretieren, erzeugen dabei aber nicht automatisch fachlich korrekte Ergebnisse. Für eine ERP-Buchung zählen vor allem korrekte Pflichtfelder, sichere Enthaltung, überprüfbare Fundstellen und Kosten pro akzeptiertem Vorgang.
Daher vergleichen wir Parser und klassische OCR, spezialisierte Document-VLMs, allgemeine Vision-Modelle und Managed-Extraktionssysteme zunächst getrennt. Erst ein gemeinsamer End-to-End-Test erlaubt eine wirtschaftliche Entscheidung zwischen vollständigen Pipelines.
Die übergeordnete Entscheidungshilfe zur KI-Dokumentenverarbeitung behandelt passende Anwendungsfälle und Kaufen-vs.-Bauen. Der Guide E-Mail → PDF → ERP zeigt die sichere technische Übergabe.
Vier Kategorien – vier unterschiedliche Aufgaben
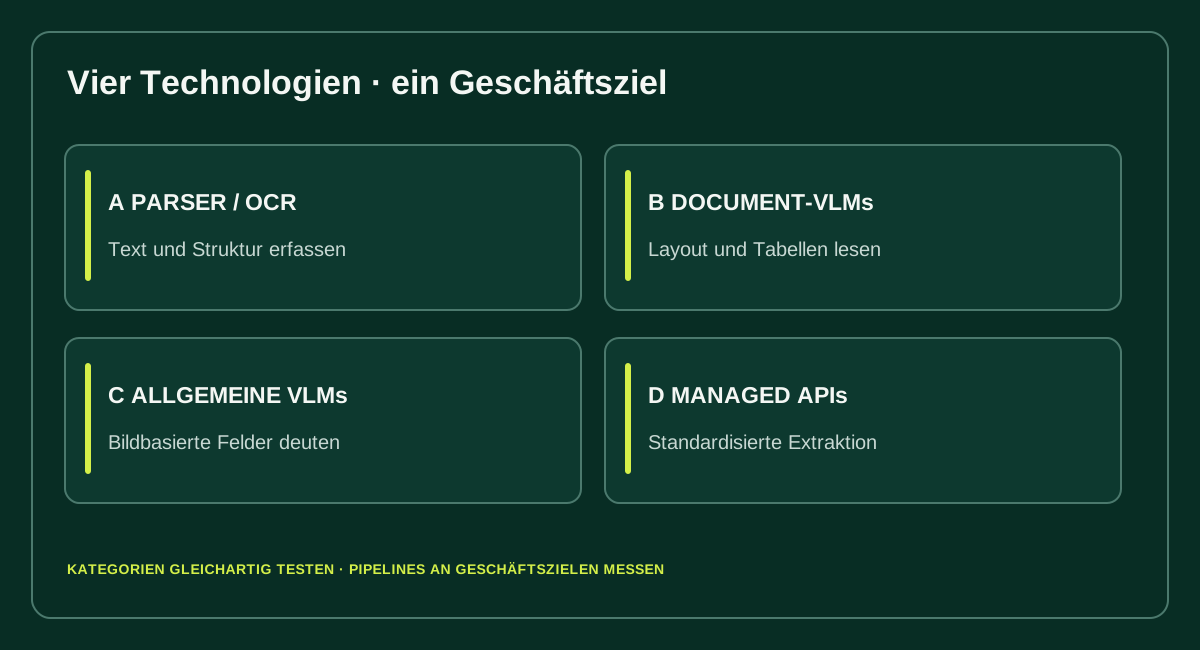 Erst Modellkategorien getrennt bewerten, dann vollständige Pipelines vergleichen.
| Kategorie | Beispiele | Primäres Ziel | Ungeeignete Schlussfolgerung |
|---|---|---|---|
| Klassische Parser und OCR | PDF-Textlayer, Tesseract; Docling mit festgelegtem Backend | Zeichen, Textpositionen, Lesereihenfolge, Struktur erfassen | „Guter OCR-Text bedeutet richtige Rechnungsbeträge.“ |
| Spezialisierte Document-/OCR-VLMs | GLM-OCR, DeepSeek-OCR 2, Qwen-OCR, PaddleOCR-VL | Dokumentbilder in Text, Markdown, Tabellen oder strukturierte Elemente überführen | „Hoher Parsing-Score beweist korrekte Buchungen.“ |
| Allgemeine Vision-Language-Modelle | Qwen3.8-27B, Gemma 4 31B | Dokumente visuell verstehen und Felder nach Schema interpretieren | „Mehr Parameter liefern automatisch bessere OCR.“ |
| Managed-Dokumentenextraktion | Google Document AI, Azure AI Document Intelligence | Produktisierte Dokumenten-/Feldextraktion per API | „Anbieter-Confidence entspricht fachlicher Sicherheit.“ |
Methodische Anmerkung: Diese Gruppen überlappen technisch. Docling ist ein Framework, kein eigenständiges Modell; ein OCR-Dienst kann intern mehrere Modelle einsetzen. Cloud-Angebote und lokale Modelle haben unterschiedliche Betriebs- und Kostenprofile. Deshalb muss jeder Ergebniswert die tatsächlich geprüfte Pipeline bezeichnen.
Was offizielle Benchmarks wirklich messen
OmniDocBench: Dokumentenparsing, nicht Buchhaltungsqualität
OmniDocBench bewertet Aspekte des Dokumentenparsings. Die Projekt-Leaderboards führen spezialisierte und allgemeine VLMs zwar in einem gemeinsamen Tabellenwerk, kennzeichnen jedoch deren Modelltyp. Einzelwerte sind nur innerhalb derselben ausgewiesenen Version, desselben Splits und derselben Metrik aussagekräftig.
Auszug aus einer dokumentierten OmniDocBench-Auswertung:
| Modell | Modelltyp | Ausgewiesener Overall-Wert |
|---|---|---|
| DeepSeek-OCR 2 | Spezialisiertes Document-VLM | 90,25 |
| Qwen3-VL-235B | Allgemeines VLM, historische Generation | 89,78 |
Quelle: OmniDocBench-Projekt-Leaderboard. Das ist keine aktuelle Qwen3.8-Messung und keine Rangliste für DACH-Rechnungen. Die Werte werden nur als dokumentierte Vergleichsbeispiele zitiert; das Projekt-README und sein Aktualisierungsstand sind für reproduzierbare Vergleiche festzuhalten.
GLM-OCR: dokumentierter Herstellerwert
Z.ai nennt für GLM-OCR (0,9B Parameter) einen Score von 94,62 auf OmniDocBench v1.5. Das Projekt beschreibt dabei eine Kombination aus Layoutanalyse und paralleler Erkennung; gemessen wird also nicht zwingend ein isolierter Modellaufruf. Der Wert stammt aus den veröffentlichten Projektangaben und ist kein hier reproduzierter eigener Test.
Quelle: GLM-OCR – offizielles Repository.
Gemma 4: andere Metrik, andere Aussage
Google nennt für Gemma 4 31B bei OmniDocBench 1.5 eine durchschnittliche Edit-Distanz von 0,131 – niedriger ist besser. Diese Zahl darf weder als 87 % Accuracy umetikettiert noch unmittelbar vom GLM-Score 94,62 abgezogen werden. Ohne identischen Evaluator, Datenstand und Metrik gibt es keinen gültigen direkten Rang.
Quelle: Google: Gemma 4 Model Card.
Ableitung: Spezialisierte kleine Modelle können bei bestimmten Dokumentaufgaben sehr stark sein; größere allgemeine VLMs sind deshalb nicht überflüssig. Die Entscheidung hängt davon ab, ob nur Text/Struktur oder auch fachliche Feldinterpretation nötig ist. Das ist eine Architekturhypothese, kein Beweis für die Qualität eines bestimmten Modells bei österreichischen Rechnungen.
Aktuelle Modellkandidaten: getrennte Prüfaufgaben
| Kandidat | Kategorie | Sinnvoller Prüfauftrag | Evidenzgrenze |
|---|---|---|---|
| GLM-OCR | Spezialisierte Document-OCR | OCR und komplexe Tabellen, lokal | Offizieller v1.5-Score; keine eigene Rechnungsfeldmessung |
| DeepSeek-OCR 2 | Spezialisierte Document-OCR | Dokument-zu-Markdown, Lesereihenfolge | Projekt- und Benchmarkdaten, keine nachgewiesene AT-Rechnungsgüte |
| Qwen-OCR / qwen-vl-ocr | Spezialisiertes OCR-API-Angebot | Text und dokumentbezogene Extraktion | API- und Modellrevision vor Test festhalten; nicht mit lokalem Qwen-VLM gleichsetzen |
| PaddleOCR-VL | Spezialisierte Document-OCR | Text, Tabellen und Layout | Exakte Version/Revision vor Messung festlegen |
| Qwen3.8-27B | Allgemeines Vision-Modell | Direktes Rechnungs-JSON aus Bild | Noch kein eigener, vergleichbarer Rechnungsbenchmark |
| Gemma 4 31B | Allgemeines Vision-Modell | Rechnungsfelder und visuelle Interpretation | Offizielle Model-Card-Metrik, kein eigener DACH-Feldtest |
| PDF-Parser / Tesseract | Deterministischer bzw. klassischer Pfad | Digitale Text-PDFs und OCR-Baseline | Nachgelagerter Feldextraktor zwingend separat messen |
| Google Document AI / Azure Document Intelligence | Managed-Extraktion | Standardisierte Rechnungsfelder und API-Betrieb | Processor/API/Region/Preisstand konkretisieren |
Die offizielle DeepSeek-OCR-2-Veröffentlichung datiert vom 27. Januar 2026. Offizielle Modellkarten, Releases und Checkpoint-IDs sind vor einem praktischen Vergleich neu zu prüfen. Qwen3-VL-Vorjahreswerte dürfen nicht als Ergebnisse von Qwen3.8 ausgegeben werden. Auch ein Familienname alleine spezifiziert noch keine Quantisierung, Bildauflösung, Promptvorlage oder Runtime.
Warum Rechnungen andere Fehler sichtbar machen
Ein OCR-Ergebnis kann nahezu perfekt aussehen und dennoch zu einem falschen Buchungsvorschlag führen. Die kritischen Fälle sind nicht unbedingt Tippfehler:
| Beispiel | Wahrscheinliches Problem | Notwendige Kontrolle |
|---|---|---|
| „Gesamtbetrag“ und „noch offen“ stehen nebeneinander | Semantisch falsches Betragsfeld | Felddefinition, Rechnungsstatus und Fundstelle prüfen |
| Rechnung und Gutschrift sehen ähnlich aus | Falsches Vorzeichen oder Belegtyp | Dokumentklassifikation plus fachliche Regeln |
| Netto, Steuer und Brutto weichen ab | Zeilen, Rundung oder Steuersatz falsch zugeordnet | Steuer- und Summenkonsistenz |
| Rechnungsnummer und Kundennummer werden verwechselt | Plausible, aber falsche Kennung | Gegen Original und Dokumentkontext validieren |
| Gleiche Rechnung trifft zweimal per E-Mail ein | Doppelte ERP-Buchung trotz guter Extraktion | Persistente Idempotenz und Dublettenprüfung |
| Dokument enthält „überweise an neue IBAN“ | Geschäftliche Änderung oder Prompt-Injection | Stammdaten-/Freigabeprüfung, keine Toolrechte für Dokumenttext |
Diese Fälle sind fachlich konstruierte Testfälle, keine dokumentierten Fehlerraten der genannten Modelle.
Der entscheidende Vergleich: fünf vollständige Pipelines
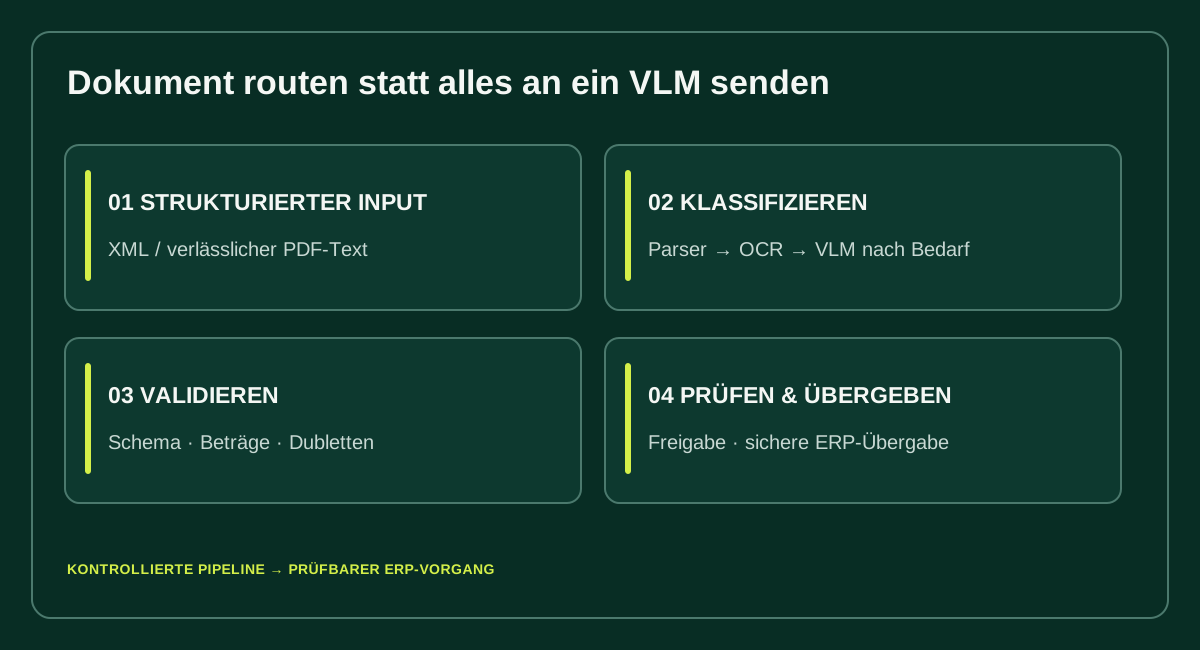 Konzeptioneller Referenzablauf, kein gemessenes Ergebnis.
Ein Käufer benötigt selten ein Modell isoliert. Er braucht einen nachvollziehbaren Workflow vom Eingang bis zur sicheren Systemübernahme.
| Pipeline | Stärken | Typischer Engpass |
|---|---|---|
| Text-PDF + Regeln | Einfach, auditierbar, ressourcenschonend | Variation von Layout und Feldsemantik |
| OCR + einheitlicher Extraktor | Auch für Scans; getrennt optimierbare Schichten | OCR-Verluste beeinflussen spätere Feldqualität |
| Document-VLM + Extraktor | Bessere Struktur bei schwierigen Seiten möglich | Vorverarbeitung, Tabellen und Schnittstellen |
| Allgemeines Vision-Modell → JSON | Visuelle Semantik und Feldinterpretation in einem Schritt | Plausibel falsche Felder, Laufzeit und Speicher |
| Hybrid: Routing + Review | Nutzt strukturierten Input zuerst und eskaliert Ausnahmen | Zusätzliche Orchestrierung und Evaluationsaufwand |
Empfehlung für einen Pilot: Strukturierte Eingänge (beispielsweise XML-Rechnungen) möglichst deterministisch parsen. Bei digitalen PDFs zunächst den Textlayer prüfen. Nur Dokumente, die diesen Weg nicht zuverlässig durchlaufen, an OCR/VLM weitergeben. Jede generierte Ausgabe bleibt ein Vorschlag bis nach Schema-, Fach- und Dublettenvalidierung. Dieser Ablauf wird im ERP-Prozessguide vertieft.
Welche Kennzahlen für die Kaufentscheidung zählen
Eine einzige „Accuracy“ ist für variable Geschäftsfelder ungeeignet. Auch Google empfiehlt für Entity-Extraktion Precision, Recall und F1 statt einer pauschalen Accuracy und dokumentiert, wie vorhergesagte Labels mit Ground Truth verglichen werden.
Quelle: Google Document AI – Evaluate performance.
| Kennzahl | Konkrete Bedeutung |
|---|---|
| OCR CER/WER | Zeichen-/Wortfehler bei der reinen Transkription |
| Feld-Exact-Match | Anteil vollständig richtig normalisierter Felder |
| Precision, Recall, F1 | Richtige, zusätzliche und fehlende Feldinstanzen |
| Document Pass Rate | Anteil der Rechnungen mit sämtlichen Pflichtfeldern korrekt |
| Stille kritische Fehler | Anteil falsch freigegebener Beträge, Währungen oder Identifikatoren |
| Review Rate und aktive Prüfzeit | Menschliche Eingriffe und Arbeitsaufwand |
| End-to-End-Latenz p50/p95 | Zeit inklusive Parsing, Modell, Validierung und Retries |
| Kosten je akzeptiertem Beleg | Infrastruktur/API plus Prüfung, Betrieb und Fehlernacharbeit |
Kostengünstigste Inferenz bedeutet nicht günstigsten Gesamtprozess. Ein schneller OCR-Lauf mit vielen manuellen Korrekturen kann schlechter abschneiden als eine teurere Pipeline mit weniger Nacharbeit.
So müsste ein fairer DACH-Rechnungsbenchmark aussehen
Für eine erste vergleichbare Pilotmessung schlagen wir 100 freigegebene oder synthetisch aufgebaute Fälle vor: 60 zum Entwickeln der Pipeline, 40 als unangetastetes Testset. Das ist ein Testdesign und keine bereits durchgeführte Messung. Reale Aussagekraft zu seltenen Fehlern erfordert später mehr Fälle.
Getrennte Dokumentgruppen: digitale Rechnungen, gescannte PDFs, Smartphone-Belege, mehrseitige Rechnungen mit Positionen sowie strukturierte elektronische Rechnungen als eigene Parser-Referenz. Zusätzlich schwierige Fälle mit Gutschriften, gemischten Steuersätzen, Fremdwährungen, Teilsummen und schlecht lesbaren Feldern.
Wichtig sind identische Zielfelder, eine vorab geprüfte Ground Truth, versionierte Normalisierung und getrennte Auswertungen pro Dokumentklasse. Die exakten Checkpoints, Prompts, Quantisierung, Hardware und Konfiguration müssen fixiert werden. Dieselben Testfälle in unterschiedlichen Varianten wiederholt auszuführen erhöht nicht die Anzahl unabhängiger Dokumente.
Freigabeschwelle: Erst wenn die Rohreports, Versionsstände, Zähler/Nenner und dokumentierten Fehlfälle nachvollziehbar vorliegen, dürfen die Pipelines als eigene gemessene Ergebnisse gegenübergestellt werden.
Fazit: Nicht das OCR-Modell kaufen, sondern den richtigen Verarbeitungsweg wählen
Die öffentlichen Benchmarks helfen bei der Vorauswahl technischer Kandidaten. Sie beantworten aber nicht unmittelbar, ob eine Pipeline deutsche und österreichische Rechnungen sicher ins ERP übertragen kann.
Für klar strukturierte Eingänge ist der einfache Parser häufig der vernünftige Ausgangspunkt. Für schwierige gescannte Dokumente sind spezialisierte Document-VLMs prüfenswert. Allgemeine Vision-Modelle wie Qwen3.8-27B oder Gemma 4 31B gehören dann in den Test, wenn die fachliche Interpretation mehr als reine Texterkennung verlangt.
Die relevante wirtschaftliche Größe ist der korrekt und sicher abgeschlossene Vorgang – nicht der schönste Markdown-Output.
Wer den geeigneten Einstieg bestimmen will, kann anhand der KI-Dokumentenverarbeitung: Verfahren, Kosten und Integrationsentscheidungen prüfen, welche Stufen standardisiert werden können und wo fachliche Freigaben bleiben müssen.
Quellen und Nachweisstatus
- OmniDocBench – Benchmark, Auswertung und Versionsangaben. Öffentliche Projektdaten, kein eigener Test.
- Z.ai – GLM-OCR. Herstellerangabe zu OmniDocBench v1.5, Modell und Pipeline.
- DeepSeek – OCR 2. Offizielle Veröffentlichung.
- Qwen – Qwen3.8-Modellfamilie. Offizielle Veröffentlichungschronik und Modelldokumentation.
- Google DeepMind – Gemma 4 Model Card. Modellbeschreibung und herstellereigene Benchmarks.
- Google Cloud – Evaluation von Document-AI-Prozessoren. Definitionen von Precision, Recall und F1.
Transparenz: Der Artikel ist eine quellengebundene Sekundäranalyse. Weder die Herstellerresultate noch ein eigener DACH-Belegbenchmark wurden hier unabhängig reproduziert. Unterschiede in Benchmark-Version, Scoring, Inputs und Pipeline erlauben keine globale Rangfolge.